Panduan Lengkap RAG (Retrieval-Augmented Generation) untuk Developer
Pelajari RAG dari nol: cara kerja pipeline retrieval-augmented generation, chunking, embedding, vector database, plus tutorial Python dan best practice produksi.
Panji Ihsanudin Fajri
15 min read0 reads
Contents
- Apa Itu RAG (Retrieval-Augmented Generation)?
- Kenapa RAG Penting
- Kapan RAG Bukan Jawabannya
- Cara Kerja RAG
- Komponen Arsitektur RAG
- Chunking: Memotong Dokumen dengan Benar
- Embedding Model
- Vector Database
- Retriever: Lebih dari Sekadar Top-K
- Generator dan Prompt
- Membangun RAG Sendiri: Tutorial Python
- RAG vs Fine-tuning vs Prompt Engineering
- Contoh Penerapan: Chatbot Dokumentasi Skala Besar
- Kesalahan Umum dan Cara Menghindarinya
- Best Practice RAG untuk Produksi
- FAQ
- Apakah RAG membutuhkan GPU?
- Berapa biaya menjalankan RAG?
- Apakah RAG bisa dipakai untuk bahasa Indonesia?
- RAG vs mesin pencari biasa, apa bedanya?
- Kapan saya harus pindah dari RAG sederhana ke arsitektur lanjutan?
- Kesimpulan
Model bahasa seperti GPT atau Claude bisa menjawab hampir apa saja, tapi jawabannya hanya sebagus data pelatihannya. Tanyakan tentang kebijakan internal perusahaanmu, dokumentasi API yang rilis bulan lalu, atau peraturan terbaru, model akan menebak dan tebakannya terdengar meyakinkan. Masalah ini punya nama: halusinasi. RAG (Retrieval-Augmented Generation) adalah teknik yang paling banyak dipakai untuk mengatasinya: sebelum menjawab, model mencari dulu dokumen yang relevan, lalu menyusun jawaban berdasarkan dokumen tersebut.
Artikel ini membahas RAG dari nol sampai bisa: definisi, alasan teknik ini penting, cara kerja pipeline-nya, komponen arsitektur, tutorial membangun RAG sendiri dengan Python, perbandingan dengan fine-tuning, studi kasus nyata, kesalahan umum, best practice, dan FAQ.
Ringkasan: RAG menggabungkan pencarian dokumen (retrieval) dengan model bahasa (generation) sehingga jawaban berdasar pada sumber yang bisa diverifikasi. Alurnya: dokumen dipecah menjadi potongan (chunk), diubah menjadi vektor embedding, disimpan di vector database; saat ada pertanyaan, sistem mencari chunk paling relevan lalu memberikannya ke LLM sebagai konteks. RAG lebih murah dan fleksibel dibanding fine-tuning untuk data yang sering berubah. Kunci kualitasnya ada di strategi chunking, pemilihan embedding model, dan evaluasi retrieval.
Apa Itu RAG (Retrieval-Augmented Generation)?
RAG (Retrieval-Augmented Generation) adalah arsitektur yang memberi model bahasa akses ke sumber pengetahuan eksternal pada saat inferensi. Alih-alih mengandalkan apa yang "diingat" dari pelatihan, model menerima potongan dokumen yang relevan sebagai konteks tambahan, lalu menghasilkan jawaban yang berlandaskan potongan tersebut.
Istilah ini diperkenalkan dalam paper Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (Lewis et al., 2020). Sejak itu RAG menjadi pola standar untuk membangun chatbot dokumentasi, asisten internal perusahaan, dan mesin tanya-jawab di atas data privat.
Contoh sederhananya begini. Kamu bertanya ke chatbot perusahaan: "Berapa batas reimbursement perjalanan dinas?" Tanpa RAG, model menjawab dari ingatannya, yang mungkin benar atau mungkin mengutip aturan tahun 2019. Dengan RAG, sistem mencari dokumen "Kebijakan Reimbursement 2025", menemukan pasal yang relevan, menempelkannya ke prompt, dan model menjawab: "Rp2.000.000 per hari, sesuai Kebijakan Reimbursement 2025 pasal 4." Jawabannya bisa dilacak ke sumbernya.
Kenapa RAG Penting
Tiga keterbatasan LLM yang langsung ditutup oleh RAG:
1. Pengetahuan yang kedaluwarsa. Model dilatih sampai tanggal tertentu. Data setelah itu tidak diketahuinya. RAG tidak peduli kapan model dilatih, karena pengetahuan datang dari dokumen yang kamu sediakan saat ini juga.
2. Data privat yang tidak boleh masuk pelatihan. Dokumen internal, basis pengetahuan pelanggan, atau repositori kode tidak bisa (dan tidak boleh) dimasukkan ke pelatihan model publik. Dengan RAG, dokumen tetap di infrastrukturmu; yang dikirim ke model hanya potongan yang relevan dengan pertanyaan.
3. Halusinasi pada pertanyaan faktual. Ketika model tidak tahu, ia cenderung mengarang dengan percaya diri. Memberinya konteks dari dokumen nyata menekan perilaku ini secara signifikan: model yang baik akan menjawab "tidak ada di dokumen" daripada mengarang, selama prompt-nya dirancang begitu.
Efek praktisnya: kamu bisa membangun asisten yang menjawab seolah "hafal" ribuan halaman dokumentasi, tanpa melatih ulang model sama sekali.
Kapan RAG Bukan Jawabannya
RAG bukan obat untuk semua masalah. Kalau kebutuhanmu adalah mengubah gaya bahasa, format output, atau perilaku model secara konsisten, itu ranahnya prompt engineering dan system prompt. Kalau model perlu mempelajari pola penalaran baru atau domain yang sangat spesifik (misalnya bahasa pemrograman baru), fine-tuning lebih tepat. Tabel perbandingan lengkapnya ada di bagian "RAG vs Fine-tuning vs Prompt Engineering" di bawah.
Cara Kerja RAG
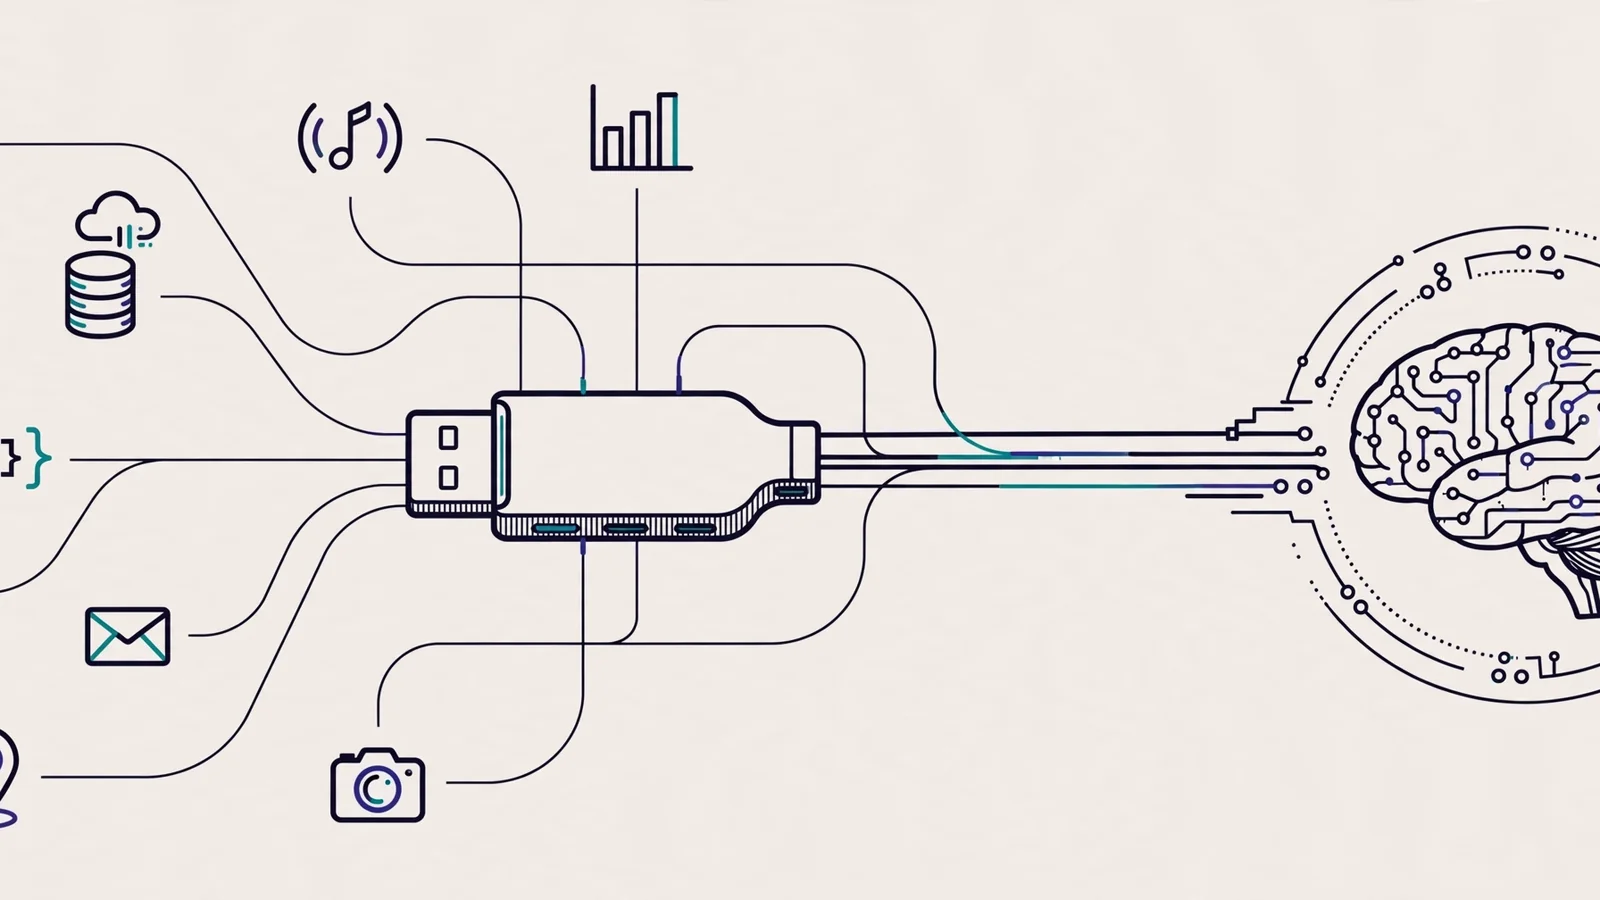
Pipeline RAG terbagi menjadi dua fase: indexing (dijalankan sekali, atau setiap dokumen berubah) dan retrieval + generation (dijalankan setiap ada pertanyaan).
Fase indexing:
- Dokumen mentah (PDF, Markdown, HTML, teks) dibersihkan dan dipecah menjadi potongan-potongan kecil yang disebut chunk.
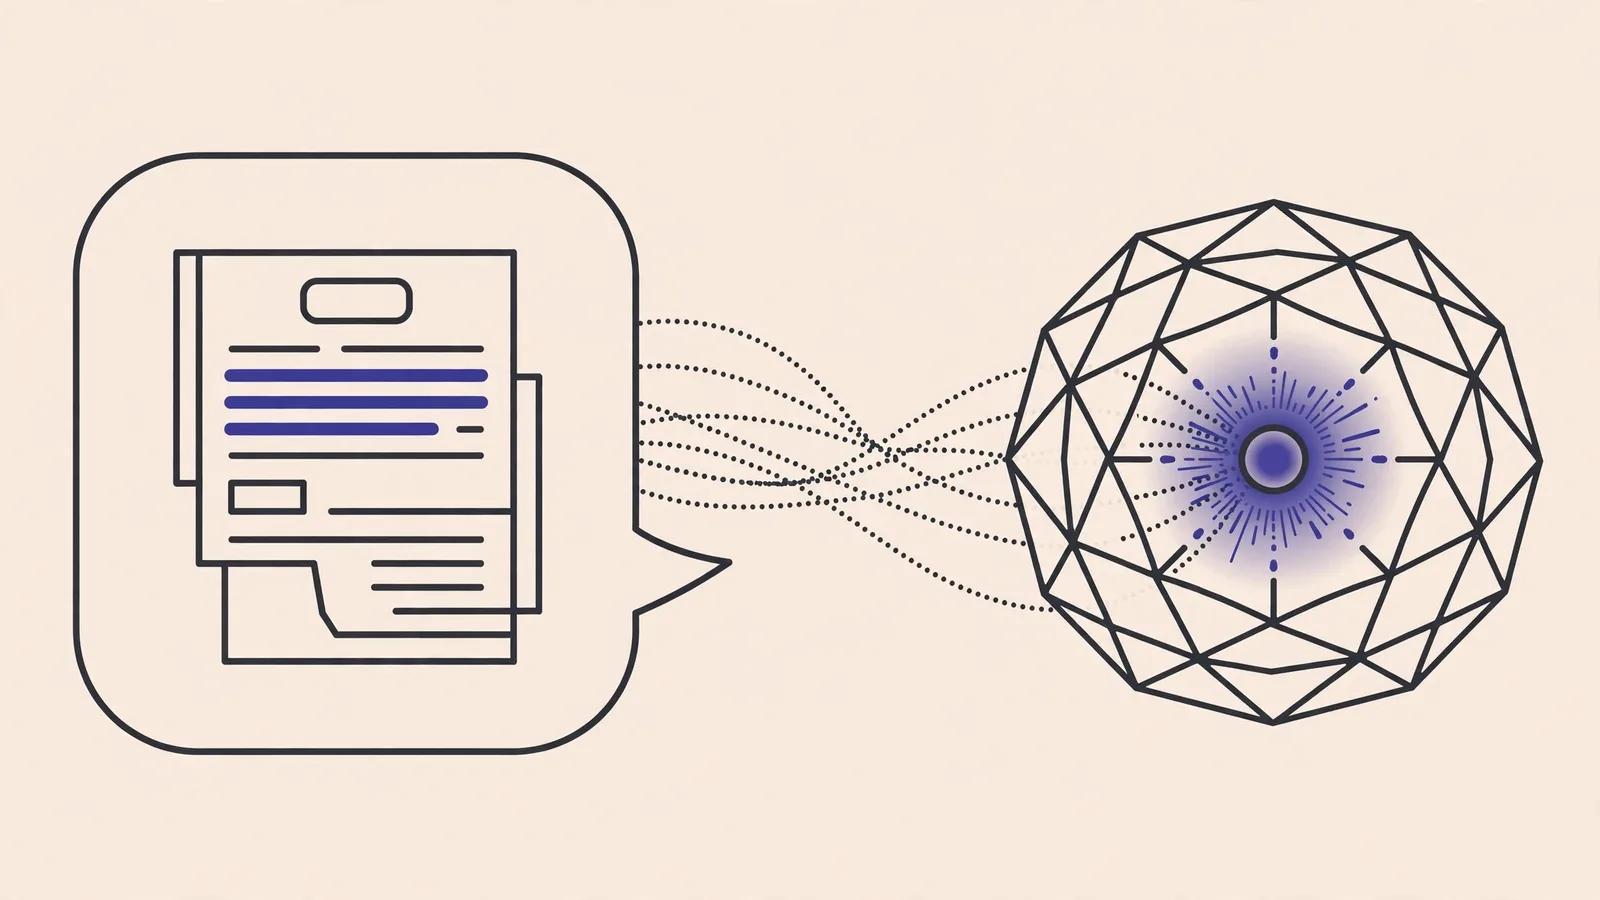
- Setiap chunk diubah menjadi embedding (vektor angka yang menangkap makna semantik teks tersebut) memakai embedding model.
- Chunk beserta embedding-nya disimpan di vector database, yang bisa mencari vektor paling mirip dengan cepat.
Fase query (saat pengguna bertanya):
- Pertanyaan pengguna diubah menjadi embedding memakai model yang sama.
- Vector database mencari chunk yang embedding-nya paling dekat (mirip secara makna, bukan sekadar kata yang sama).
- Chunk teratas (misalnya 3–5 potong) disisipkan ke prompt bersama pertanyaan asli.
- LLM membaca konteks itu dan menyusun jawaban.
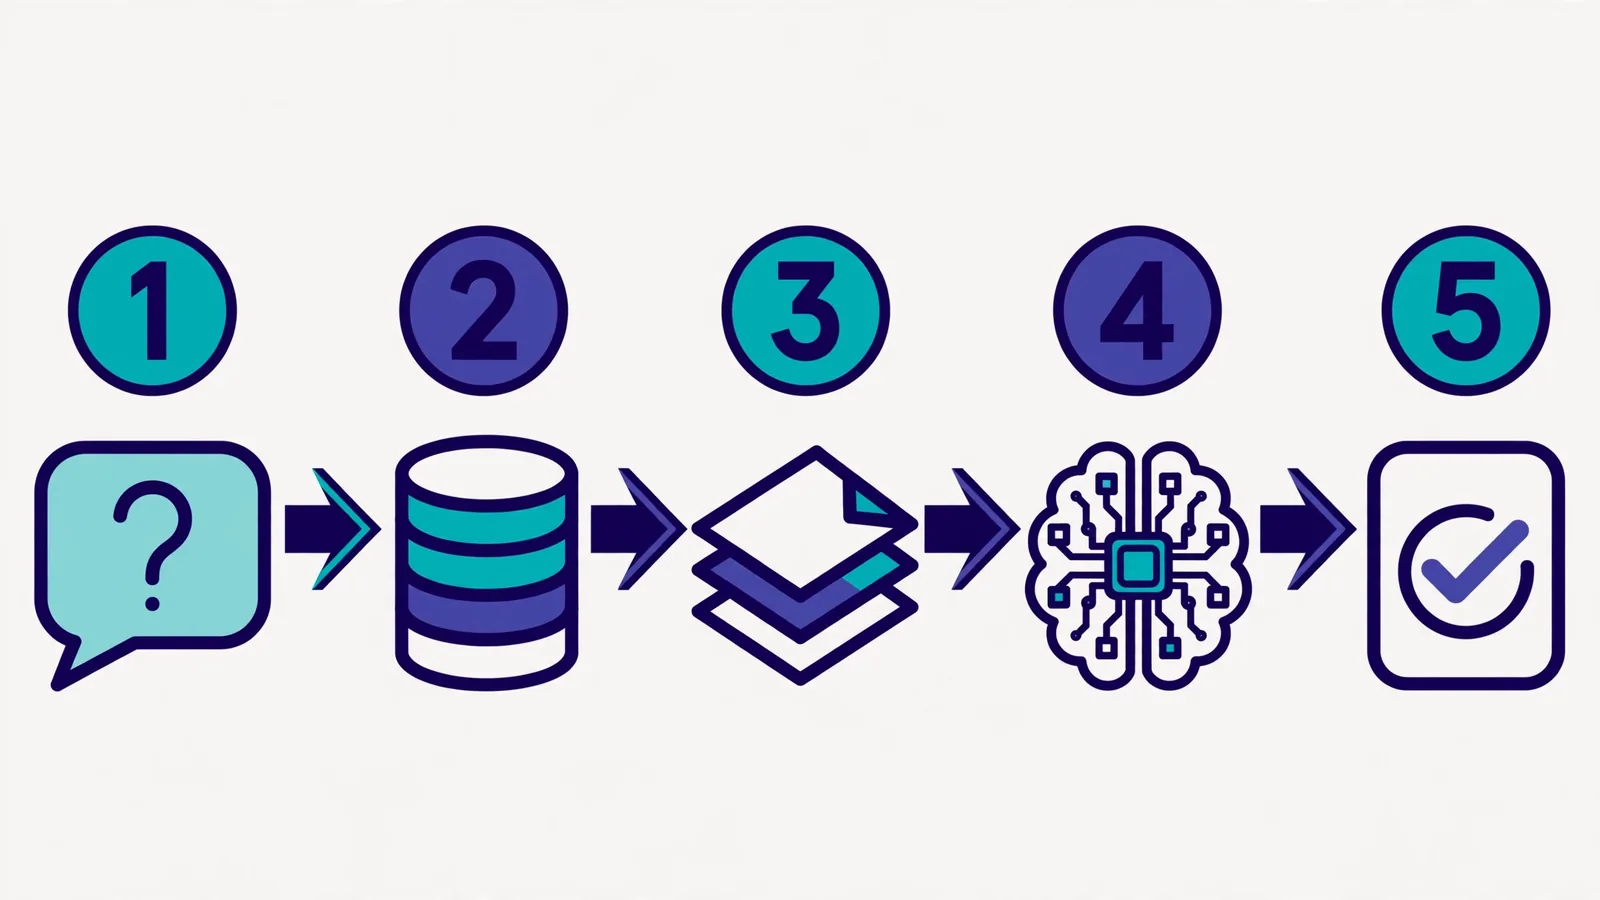
Kuncinya ada di langkah 2 fase query: pencariannya bersifat semantik. Pertanyaan "bagaimana cara reset password?" akan cocok dengan dokumen berjudul "Pemulihan Akses Akun" meski tidak ada kata yang sama persis, karena embedding keduanya berdekatan di ruang vektor.
Secara matematis, kedekatan biasanya diukur dengan cosine similarity, yaitu sudut antara dua vektor. Skor 1 berarti identik arahnya, 0 berarti tidak berhubungan. Vector database modern (Pinecone, Weaviate, Qdrant, pgvector) menghitung ini untuk jutaan vektor dalam hitungan milidetik memakai indeks ANN (Approximate Nearest Neighbors).
Komponen Arsitektur RAG
Chunking: Memotong Dokumen dengan Benar
Chunking adalah keputusan paling berpengaruh yang paling sering diremehkan. Chunk terlalu besar membuat konteks yang diambil berisik; chunk terlalu kecil membuat makna terpotong.
Strategi yang umum dipakai:
- Fixed-size chunking: potong setiap N token (misalnya 512) dengan overlap 50–100 token. Sederhana dan cukup baik untuk teks umum.
- Recursive chunking: potong berdasarkan struktur (paragraf dulu, lalu kalimat) supaya batas chunk mengikuti batas makna alami. Ini default yang bagus di kebanyakan kasus.
- Semantic chunking: potong di titik di mana topik berubah, dideteksi dari pergeseran embedding antar kalimat. Lebih mahal, tapi rapi untuk dokumen panjang yang campur aduk.
- Document-aware chunking: hormati struktur dokumen (satu fungsi kode per chunk, satu bagian Markdown per chunk). Wajib untuk basis kode dan dokumentasi teknis.
Aturan praktis: mulai dari recursive chunking 512 token dengan overlap 10–20%, lalu ukur. Jangan menebak; ukur dengan evaluasi retrieval (dibahas di best practice).
Embedding Model
Embedding model mengubah teks menjadi vektor. Pilihannya menentukan seberapa "paham" sistemmu soal kemiripan makna. Beberapa opsi populer:
| Model | Dimensi | Catatan |
|---|---|---|
text-embedding-3-small (OpenAI) |
1.536 | Murah, cepat, cukup untuk kebanyakan kasus |
text-embedding-3-large (OpenAI) |
3.072 | Akurasi lebih tinggi, biaya lebih besar |
multilingual-e5-large |
1.024 | Open source, kuat untuk bahasa Indonesia |
bge-m3 |
1.024 | Open source, mendukung pencarian dense + sparse sekaligus |
Untuk konten berbahasa Indonesia, model multilingual seperti E5 atau BGE biasanya mengalahkan model yang hanya dilatih di bahasa Inggris. Detail lengkap soal memilih dan memakai embedding ada di dokumentasi embeddings OpenAI dan model E5 di Hugging Face.
Satu aturan keras: embedding model untuk indexing dan query harus sama persis. Vektor dari dua model berbeda tidak bisa dibandingkan.
Vector Database
Vector database menyimpan jutaan embedding dan melayani pencarian kemiripan dalam milidetik. Pilihan tergantung skala dan di mana kamu beroperasi:
- pgvector — ekstensi Postgres. Pilihan paling pragmatis kalau datamu sudah di Postgres dan skala di bawah beberapa juta chunk.
- Qdrant / Weaviate — open source, self-hostable, fitur filtering metadata yang matang.
- Pinecone — managed, tanpa operasi server. Panduan konsepnya yang rapi bisa dibaca di Pinecone Learn: RAG.
- Chroma — ringan, populer untuk prototyping dan berjalan lokal.
Untuk metadata, simpan selalu: sumber dokumen, judul, tanggal, dan nomor halaman/bagian. Metadata ini dipakai untuk filtering ("cari hanya di dokumen tahun 2025") dan untuk menampilkan sitasi ke pengguna.
Retriever: Lebih dari Sekadar Top-K
Retriever dasar mengambil K chunk paling mirip. Di produksi, tiga peningkatan ini memberi lompatan kualitas terbesar:
- Hybrid search menggabungkan pencarian vektor (makna) dengan BM25/keyword (kata persis). Berguna untuk kode, nomor pasal, dan nama produk yang harus cocok harfiah.
- Reranking mengambil 20–50 kandidat dengan pencarian cepat, lalu mengurutkan ulang dengan model cross-encoder yang lebih teliti untuk memilih 5 terbaik. Mahal per query, tapi akurasinya jauh lebih baik.
- Query transformation menulis ulang atau memecah pertanyaan pengguna sebelum dicari. "Bagaimana cara reset password dan ganti email?" lebih baik dipecah jadi dua query terpisah.
Generator dan Prompt
LLM hanya sebagus instruksi yang diterimanya. System prompt untuk RAG perlu tiga hal: perintah untuk hanya menjawab dari konteks yang diberikan, format sitasi yang jelas, dan perilaku saat konteks tidak cukup. Contoh pola yang bekerja:
"Jawablah hanya berdasarkan konteks di bawah. Cantumkan nomor sumber untuk setiap klaim faktual, misalnya [1]. Jika jawabannya tidak ada di konteks, katakan 'Saya tidak menemukan jawabannya di dokumen yang tersedia' — jangan mengarang."
Teknik menyusun instruksi seperti ini dibahas tuntas di panduan prompt engineering; RAG dan prompt engineering saling melengkapi, bukan saling menggantikan.
Membangun RAG Sendiri: Tutorial Python
Bagian ini membangun pipeline RAG minimal dari nol supaya kamu paham setiap bagiannya. Kita pakai OpenAI untuk embedding dan chat, plus pencarian cosine similarity murni dengan NumPy (tanpa vector database), agar tidak ada bagian yang tersembunyi.
Instal dulu dependensinya:
pip install openai numpy
Langkah 1 — Siapkan dokumen dan chunking. Kita pakai recursive chunking sederhana berbasis paragraf:
def chunk_text(text: str, max_chars: int = 1500, overlap: int = 200) -> list[str]:
    """Split text into overlapping chunks on paragraph boundaries."""
    paragraphs = [p.strip() for p in text.split("\n\n") if p.strip()]
    chunks, current = [], ""
    for para in paragraphs:
        if len(current) + len(para) <= max_chars:
            current += ("\n\n" if current else "") + para
        else:
            chunks.append(current)
            # keep the tail as overlap for the next chunk
            current = current[-overlap:] + "\n\n" + para if len(current) > overlap else para
    if current:
        chunks.append(current)
    return chunks
Langkah 2 — Buat embedding untuk setiap chunk. Satu panggilan API bisa memproses banyak teks sekaligus (batching):
from openai import OpenAI
import numpy as np

client = OpenAI()

def embed(texts: list[str]) -> np.ndarray:
    """Return L2-normalized embeddings for a batch of texts."""
    resp = client.embeddings.create(model="text-embedding-3-small", input=texts)
    vecs = np.array([d.embedding for d in resp.data], dtype=np.float32)
    return vecs / np.linalg.norm(vecs, axis=1, keepdims=True)
Normalisasi L2 di sini penting: vektor yang sudah dinormalisasi membuat cosine similarity setara dengan dot product sederhana, jadi pencarian jadi satu perkalian matriks.
Langkah 3 — Retrieval dengan cosine similarity. Karena sudah dinormalisasi, skor kemiripan = dot product:
def retrieve(query: str, chunks: list[str], chunk_vecs: np.ndarray, top_k: int = 4):
    """Return the top_k most similar chunks for a query."""
    q_vec = embed([query])[0]
    scores = chunk_vecs @ q_vec
    top_idx = np.argsort(scores)[::-1][:top_k]
    return [(chunks[i], float(scores[i])) for i in top_idx]
Untuk data kecil (ribuan chunk) ini cukup dan transparan. Saat datamu tumbuh ke ratusan ribu chunk, pindahkan langkah ini ke vector database seperti Qdrant atau pgvector; interface-nya sama: masukkan vektor, minta yang paling mirip.
Langkah 4 — Generation dengan konteks. Tempelkan chunk terambil ke prompt dan minta model menjawab dengan sitasi:
def answer(question: str, chunks: list[str], chunk_vecs: np.ndarray) -> str:
    hits = retrieve(question, chunks, chunk_vecs)
    context = "\n\n".join(f"[{i+1}] {text}" for i, (text, _) in enumerate(hits))
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system",
             "content": "Jawablah hanya berdasarkan konteks bernomor di bawah. "
                        "Sertakan nomor sumber seperti [1] untuk setiap klaim faktual. "
                        "Jika jawabannya tidak ada di konteks, katakan terus terang."},
            {"role": "user",
             "content": f"Konteks:\n{context}\n\nPertanyaan: {question}"},
        ],
    )
    return resp.choices[0].message.content
Itu saja — empat fungsi, dan kamu sudah punya RAG yang bekerja. Dari sini, peningkatan terbesar biasanya datang dari kualitas chunking dan evaluasi, bukan dari mengganti model yang lebih besar.
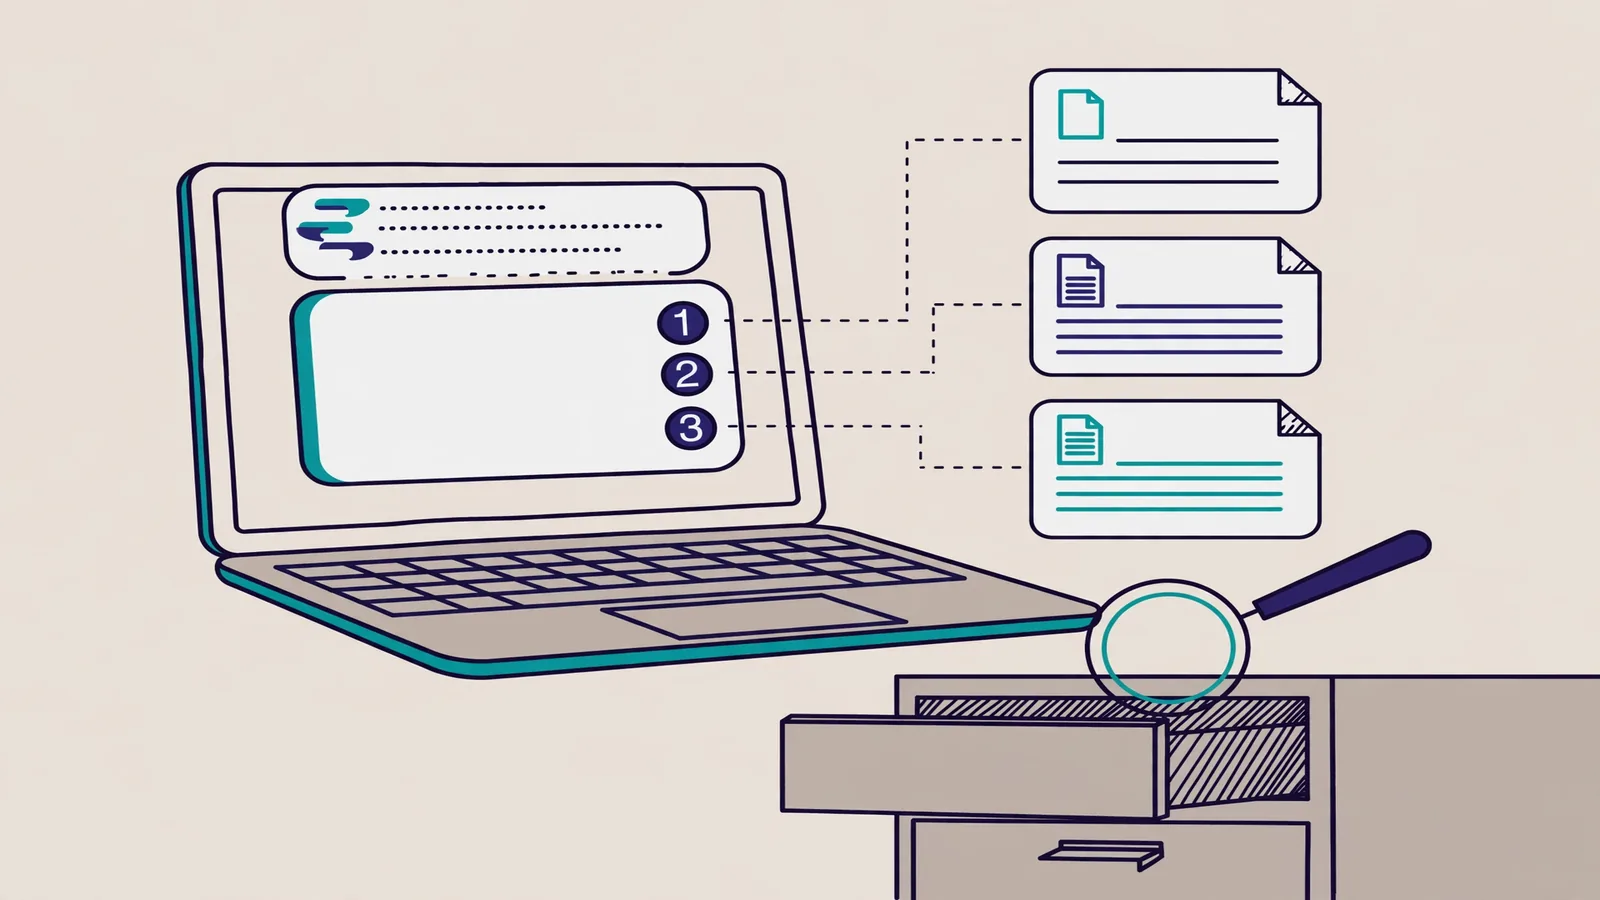
RAG vs Fine-tuning vs Prompt Engineering
Tiga teknik ini sering dipertukarkan, padahal menyelesaikan masalah berbeda.
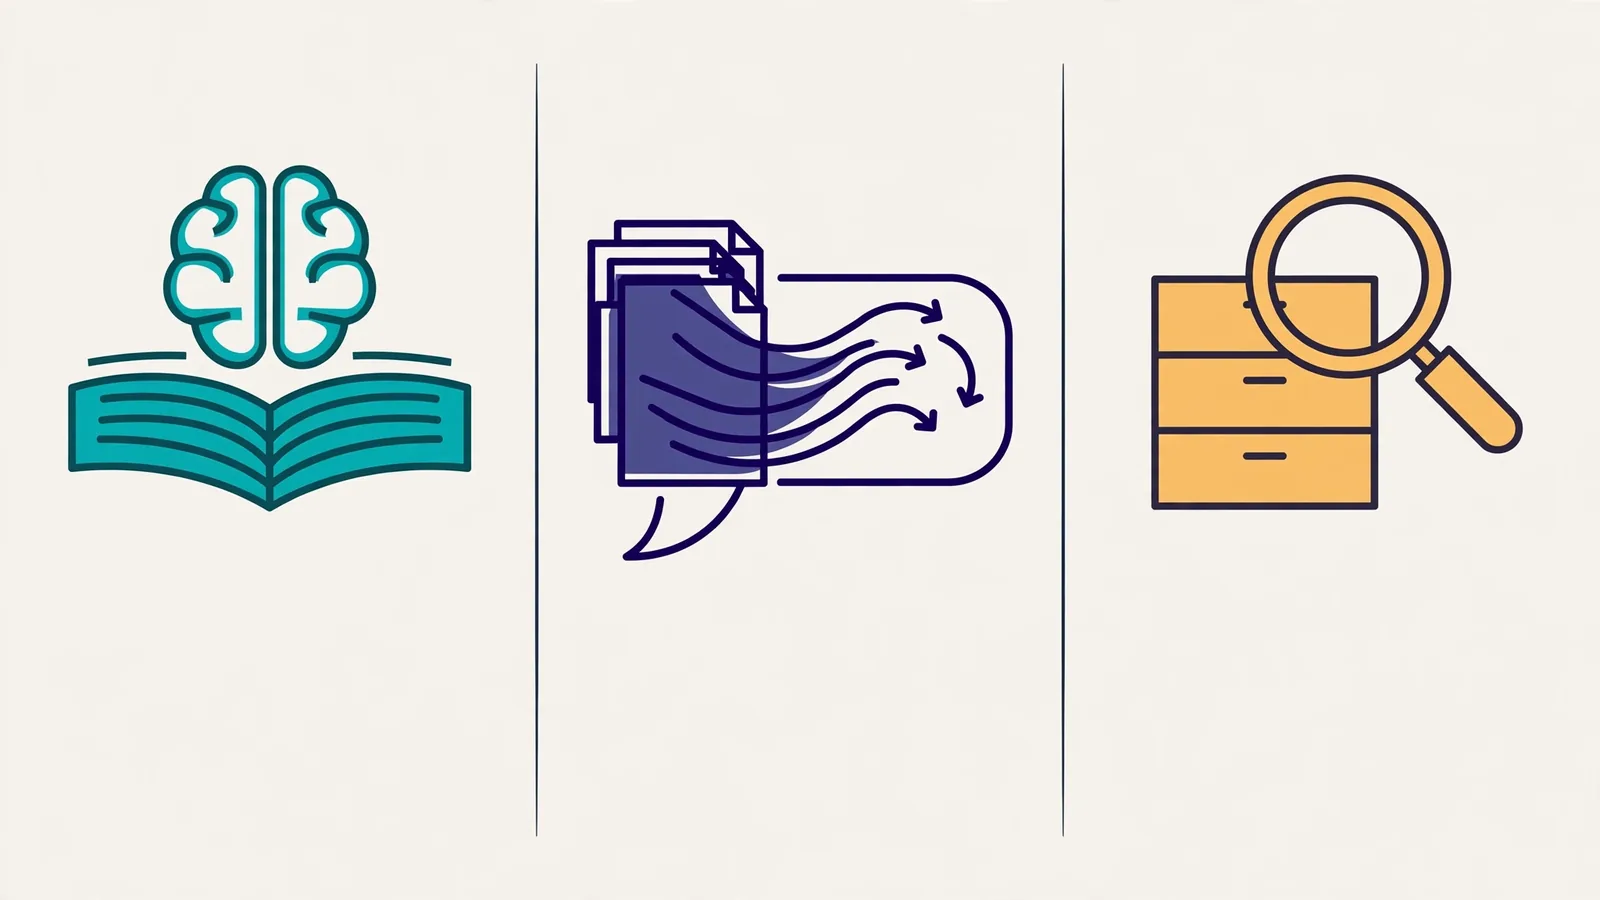
| Aspek | RAG | Fine-tuning | Prompt Engineering |
|---|---|---|---|
| Masalah yang diselesaikan | Menjawab dari pengetahuan eksternal/terbaru | Mengubah perilaku, gaya, atau pengetahuan inti model | Mengarahkan output lewat instruksi |
| Biaya | Rendah (embedding + storage) | Tinggi (GPU, data latih) | Hampir nol |
| Data berubah-ubah | Sangat baik (update dokumen saja) | Buruk (harus latih ulang) | Netral |
| Butuh data latih | Tidak | Ya, ratusan–ribuan contoh | Tidak |
| Risiko halusinasi | Rendah bila konteks bagus | Tetap ada | Tetap ada |
| Kapan dipakai | FAQ, dokumentasi, data internal | Gaya bahasa khusus, domain reasoning | Format output, tone, batasan |
Aturan keputusannya sederhana: kalau pengetahuan yang dibutuhkan bisa ditulis sebagai dokumen, pakai RAG. Kalau yang dibutuhkan adalah perilaku atau kemampuan baru, pertimbangkan fine-tuning. Kombinasi ketiganya justru umum di produksi: RAG untuk pengetahuan, prompt engineering untuk format dan batasan, fine-tuning sesekali untuk perilaku khusus.
Contoh Penerapan: Chatbot Dokumentasi Skala Besar
Bagian ini adalah ilustrasi komposit: rangkuman pola yang umum dipakai tim platform saat membangun chatbot di atas dokumentasi besar, bukan laporan tentang satu perusahaan tertentu. Anggap dokumentasi API dengan 12.000 halaman dalam tiga versi, dan tim support yang separuh waktunya habis menjawab pertanyaan yang sebenarnya terjawab di docs.
Pola arsitektur yang biasanya dipakai:
- Ingest: crawler mengambil Markdown dari repo docs setiap ada rilis; chunking mengikuti struktur heading (satu section = satu chunk, maksimal 800 token).
- Metadata: setiap chunk menyimpan versi docs, URL halaman, dan tanggal rilis. Query difilter ke versi terbaru kecuali pengguna menyebut versi lama.
- Retrieval: hybrid search (vektor + BM25) mengambil 30 kandidat, lalu cross-encoder reranker memilih 6 terbaik.
- Evaluasi: 200 pertanyaan nyata dari tiket support dijadikan golden set; metriknya adalah jawaban yang dinilai benar oleh reviewer manusia.
Dua keputusan yang paling menentukan hasil pada pola seperti ini. Pertama, filtering versi dokumen: tanpanya, sepertiga jawaban bisa merujuk ke dokumentasi kedaluwarsa. Kedua, reranker, yang pada banyak kasus memberi kenaikan akurasi lebih besar daripada mengganti embedding model yang lebih mahal.
Pelajaran yang bisa dibawa pulang: RAG yang bagus adalah soal rekayasa data — kualitas chunk, metadata, dan evaluasi — bukan soal model terbesar. Kalau kamu membangun yang serupa, ukur tiga angka ini sejak minggu pertama: recall@k retrieval, persentase jawaban "tidak tahu", dan persentase jawaban yang dikoreksi manusia.
Kesalahan Umum dan Cara Menghindarinya
- Chunk asal potong. Memotong tepat 512 token di tengah kalimat menghancurkan konteks. Pakai batas struktur (paragraf, heading) dan overlap. Kalau jawaban sering terpotong di tengah, chunking adalah tersangka pertama.
- Tidak menyimpan metadata sumber. Tanpa sumber, kamu tidak bisa menampilkan sitasi, tidak bisa filter per versi, dan tidak bisa debug kenapa jawaban salah. Simpan metadata sejak hari pertama.
- Top-k terlalu kecil atau terlalu besar. K=2 membuat konteks miskin; K=20 membuat prompt berisik dan mahal. Mulai dari 4–6, ukur, lalu sesuaikan.
- Mengirim seluruh dokumen ke prompt. Itu bukan RAG, itu "long context stuffing". Mahal, lambat, dan model cenderung mengabaikan bagian tengah konteks (fenomena lost in the middle).
- Tidak ada evaluasi. "Kelihatannya bagus" bukan metrik. Kumpulkan 50–100 pasang pertanyaan-jawaban yang benar, jalankan pipeline terhadapnya setiap ada perubahan, dan catat skornya.
- Percaya penuh pada jawaban. RAG menekan halusinasi, bukan menghilangkannya. Untuk keputusan penting, tampilkan sumbernya dan biarkan manusia memverifikasi.
Best Practice RAG untuk Produksi
- Evaluasi retrieval dan generation secara terpisah. Retrieval diukur dengan recall@k (apakah chunk yang benar masuk dalam K teratas?); generation diukur dengan kebenaran jawaban menurut manusia atau LLM-as-judge. Kalau jawaban salah, kamu harus tahu komponen mana yang gagal.
- Beri ID stabil pada chunk. Saat dokumen diperbarui, kamu perlu tahu chunk mana yang diganti, bukan mengindeks ulang semuanya dari nol.
- Batasi dan sanitasi input. Potong panjang query yang tidak wajar, dan jangan pernah menempelkan data sensitif pengguna ke konteks yang bisa bocor ke log.
- Cache embedding untuk dokumen statis. Embedding tidak berubah selama teks dan modelnya sama — tidak ada alasan menghitung ulang setiap deploy.
- Tampilkan sitasi di UI. Selain membangun kepercayaan, sitasi adalah alat debug gratis: pengguna yang melaporkan jawaban salah sekaligus menunjukkan sumber yang keliru.
- Pantau query yang gagal. Log pertanyaan yang dijawab "tidak tahu" — itu adalah peta jalan konten: dokumen yang belum ada atau chunking yang perlu diperbaiki.
- Pisahkan indeks per tenant untuk data multi-pelanggan. Jangan mengandalkan filter metadata saja untuk isolasi data sensitif antar pelanggan.
FAQ
Apakah RAG membutuhkan GPU?
Tidak untuk pipeline dasar. Embedding bisa lewat API (OpenAI, Cohere) atau model open source yang berjalan di CPU untuk skala kecil. GPU baru relevan kalau kamu menjalankan embedding model atau reranker sendiri dalam volume besar, atau melakukan fine-tuning.
Berapa biaya menjalankan RAG?
Untuk skala kecil-menengah, biayanya didominasi panggilan API. Contoh kasar: mengindeks 10.000 chunk dengan text-embedding-3-small biayanya di bawah satu dolar AS; setiap pertanyaan menghabiskan embedding satu query plus token konteks 4–6 chunk (sekitar 3.000–4.000 token) — jauh lebih murah daripada fine-tuning model.
Apakah RAG bisa dipakai untuk bahasa Indonesia?
Bisa, dengan catatan memilih embedding model multilingual (seperti multilingual-e5 atau bge-m3) dan menguji retrieval dalam bahasa Indonesia — bukan sekadar menerjemahkan evaluasi bahasa Inggris. Kualitas chunking untuk teks Indonesia juga perlu dicek manual karena pola kalimatnya berbeda.
RAG vs mesin pencari biasa, apa bedanya?
Mesin pencari mengembalikan daftar dokumen; pengguna yang membaca dan menyimpulkan. RAG melangkah lebih jauh: ia membaca dokumen yang ditemukan lalu menyusun jawaban langsung dalam bahasa natural, lengkap dengan sitasi. Pencarian adalah komponen di dalam RAG, bukan penggantinya.
Kapan saya harus pindah dari RAG sederhana ke arsitektur lanjutan?
Saat metrik evaluasimu mentok. Kalau recall@5 retrieval-mu sudah di atas 90% tapi jawaban masih salah, masalahnya di generator/prompt. Kalau retrieval-nya yang buruk, tambahkan hybrid search dan reranker sebelum menyentuh model yang lebih besar. Ukur dulu, optimasi kemudian.
Kesimpulan
RAG adalah cara paling praktis untuk membuat LLM menjawab berdasarkan pengetahuan yang aktual, privat, dan bisa diverifikasi — tanpa biaya dan kerumitan pelatihan ulang. Intinya hanya empat langkah: pecah dokumen menjadi chunk, ubah menjadi embedding, cari yang paling relevan untuk setiap pertanyaan, dan biarkan model menyusun jawaban dari konteks tersebut.
Langkah berikutnya yang paling berdampak: bangun pipeline minimal seperti di tutorial di atas dengan dokumentasimu sendiri, kumpulkan 50 pertanyaan nyata sebagai set evaluasi, lalu iterasi pada chunking dan retrieval. Kualitas RAG hampir selalu ditentukan oleh rekayasa datanya, bukan oleh besarnya model.
Untuk melengkapi, pelajari juga cara menyusun prompt yang efektif untuk RAG di panduan prompt engineering — karena generator RAG yang baik pada akhirnya adalah soal instruksi yang tepat.