Strategi Caching dengan Redis: Cache-Aside, Write-Through, dan Invalidasi yang Benar
Pelajari strategi caching Redis untuk backend production: pola cache-aside, write-through, write-behind, pengaturan TTL, dan teknik cache invalidation yang aman — lengkap dengan contoh kode Python.
Panji Ihsanudin Fajri
12 min read0 reads
Contents
- Apa itu caching dan kenapa Redis cocok untuk itu
- Cara kerja caching di Redis
- Empat strategi caching yang perlu kamu tahu
- Cache-Aside
- Read-Through
- Write-Through
- Write-Behind
- Tutorial: cache-aside dengan Python
- Invalidasi cache tanpa drama
- TTL-based
- Event-based invalidation
- Versioning key
- Proteksi stampede
- Kesalahan umum dan cara menghindarinya
- Best practice caching Redis
- FAQ
- Berapa TTL yang ideal untuk cache Redis?
- Kapan memakai write-through dan kapan write-behind?
- Apakah Redis bisa kehilangan data cache?
- Bagaimana cara menangani cache stampede?
- Kesimpulan
Endpoint daftar produkmu menembak 40 query ke database setiap kali dibuka. Traffic naik dua kali lipat, latensi ikut melesat, dan database mulai megap-megap. Kabar baiknya: masalah seperti ini jarang butuh replica database baru — biasanya cukup lapisan cache yang dirancang dengan benar.
Di artikel ini kamu akan belajar caching Redis untuk backend production: empat pola strategi caching yang umum dipakai, cara mengatur Redis TTL dan invalidasi dengan aman, sampai contoh kode Python yang siap kamu adaptasi.
Ringkasan:
- Pola cache aside adalah yang paling fleksibel untuk kebanyakan aplikasi: aplikasi mengecek cache dulu, baru membaca database saat terjadi miss.
- TTL yang tepat lebih penting daripada ukuran cache yang besar — data basi lebih berbahaya daripada sekadar cache miss.
- Pilih strategi tulis berdasarkan toleransimu terhadap kehilangan data: write-through cache aman tapi lebih lambat, write-behind cepat tapi berisiko.
- Cache invalidation butuh rencana eksplisit — event-based invalidation atau versioning key, bukan sekadar berharap TTL menyelamatkanmu.
Apa itu caching dan kenapa Redis cocok untuk itu
Caching berarti menyimpan hasil dari operasi yang mahal — query database yang kompleks, respons API pihak ketiga, hasil agregasi — di tempat yang bisa dibaca jauh lebih cepat. Alih-alih menghitung ulang setiap kali, aplikasi mengambil salinan yang sudah jadi.
Redis cocok untuk peran ini karena beberapa alasan praktis. Pertama, ia menyimpan data di memori, sehingga operasi baca tulis selesai dalam hitungan milidetik tanpa menyentuh disk. Kedua, ia bukan sekadar key-value polos: ada hash, list, set, dan sorted set yang memudahkanmu memodelkan berbagai kebutuhan cache tanpa serialisasi yang aneh-aneh. Ketiga, dukungan TTL-nya bersifat bawaan — kamu bisa menentukan masa kedaluwarsa per key tanpa membangun janitor sendiri. Keempat, operasinya atomik, jadi aman dipakai banyak worker sekaligus.
Kalau kamu belum pernah menjalankannya, panduan menjalankan Redis lewat Docker membahas cara memutar instance lokal dalam hitungan menit. Untuk artikel ini, anggap saja kamu sudah punya Redis yang bisa diakses di localhost:6379.
Cara kerja caching di Redis
Inti Redis adalah pasangan key-value. Key selalu berupa string biner-aman seperti product:42 atau session:9f3a, sedangkan value bisa berupa string, hash, list, set, atau sorted set. Untuk caching, pola paling umum adalah string berisi JSON hasil serialisasi — sederhana, mudah di-debug, dan bisa dibaca bahasa pemrograman apa pun.
Setiap key bisa diberi masa kedaluwarsa lewat perintah EXPIRE, atau langsung saat penulisan dengan SETEX dan opsi EX pada SET. TTL dihitung dalam detik; begitu waktunya habis, Redis menghapus key tersebut secara otomatis. Inilah fondasi strategi kedaluwarsa: kamu tidak perlu kode pembersih, cukup tentukan berapa lama sebuah data boleh dianggap segar.
Hal yang sering luput: memori Redis terbatas, dan perilakunya saat penuh ditentukan kebijakan eviksi. Kebijakan default Redis (self-hosted) adalah noeviction — artinya saat memori penuh, perintah tulis baru ditolak dengan error, bukan diam-diam menghapus data lama. Untuk server yang difungsikan murni sebagai cache, allkeys-lru jauh lebih masuk akal: Redis membuang key yang paling lama tidak diakses untuk memberi ruang bagi data baru. Salah memilih kebijakan di sini adalah sumber klasik insiden "tiba-tiba write gagal padahal kemarin baik-baik saja".
Operasi dasarnya hanya segelintir: GET untuk membaca, SETEX untuk menulis dengan TTL, DEL untuk menghapus, dan EXPIRE untuk mengatur ulang masa hidup key yang sudah ada. Hampir seluruh strategi caching yang dibahas di artikel ini dibangun dari kombinasi keempat perintah itu plus satu dua perintah bantu.
Empat strategi caching yang perlu kamu tahu
Memilih strategi caching berarti menjawab dua pertanyaan: siapa yang mengisi cache, dan kapan data ditulis ke penyimpanan utama. Empat pola di bawah mencakup hampir semua kasus di backend.
Cache-Aside
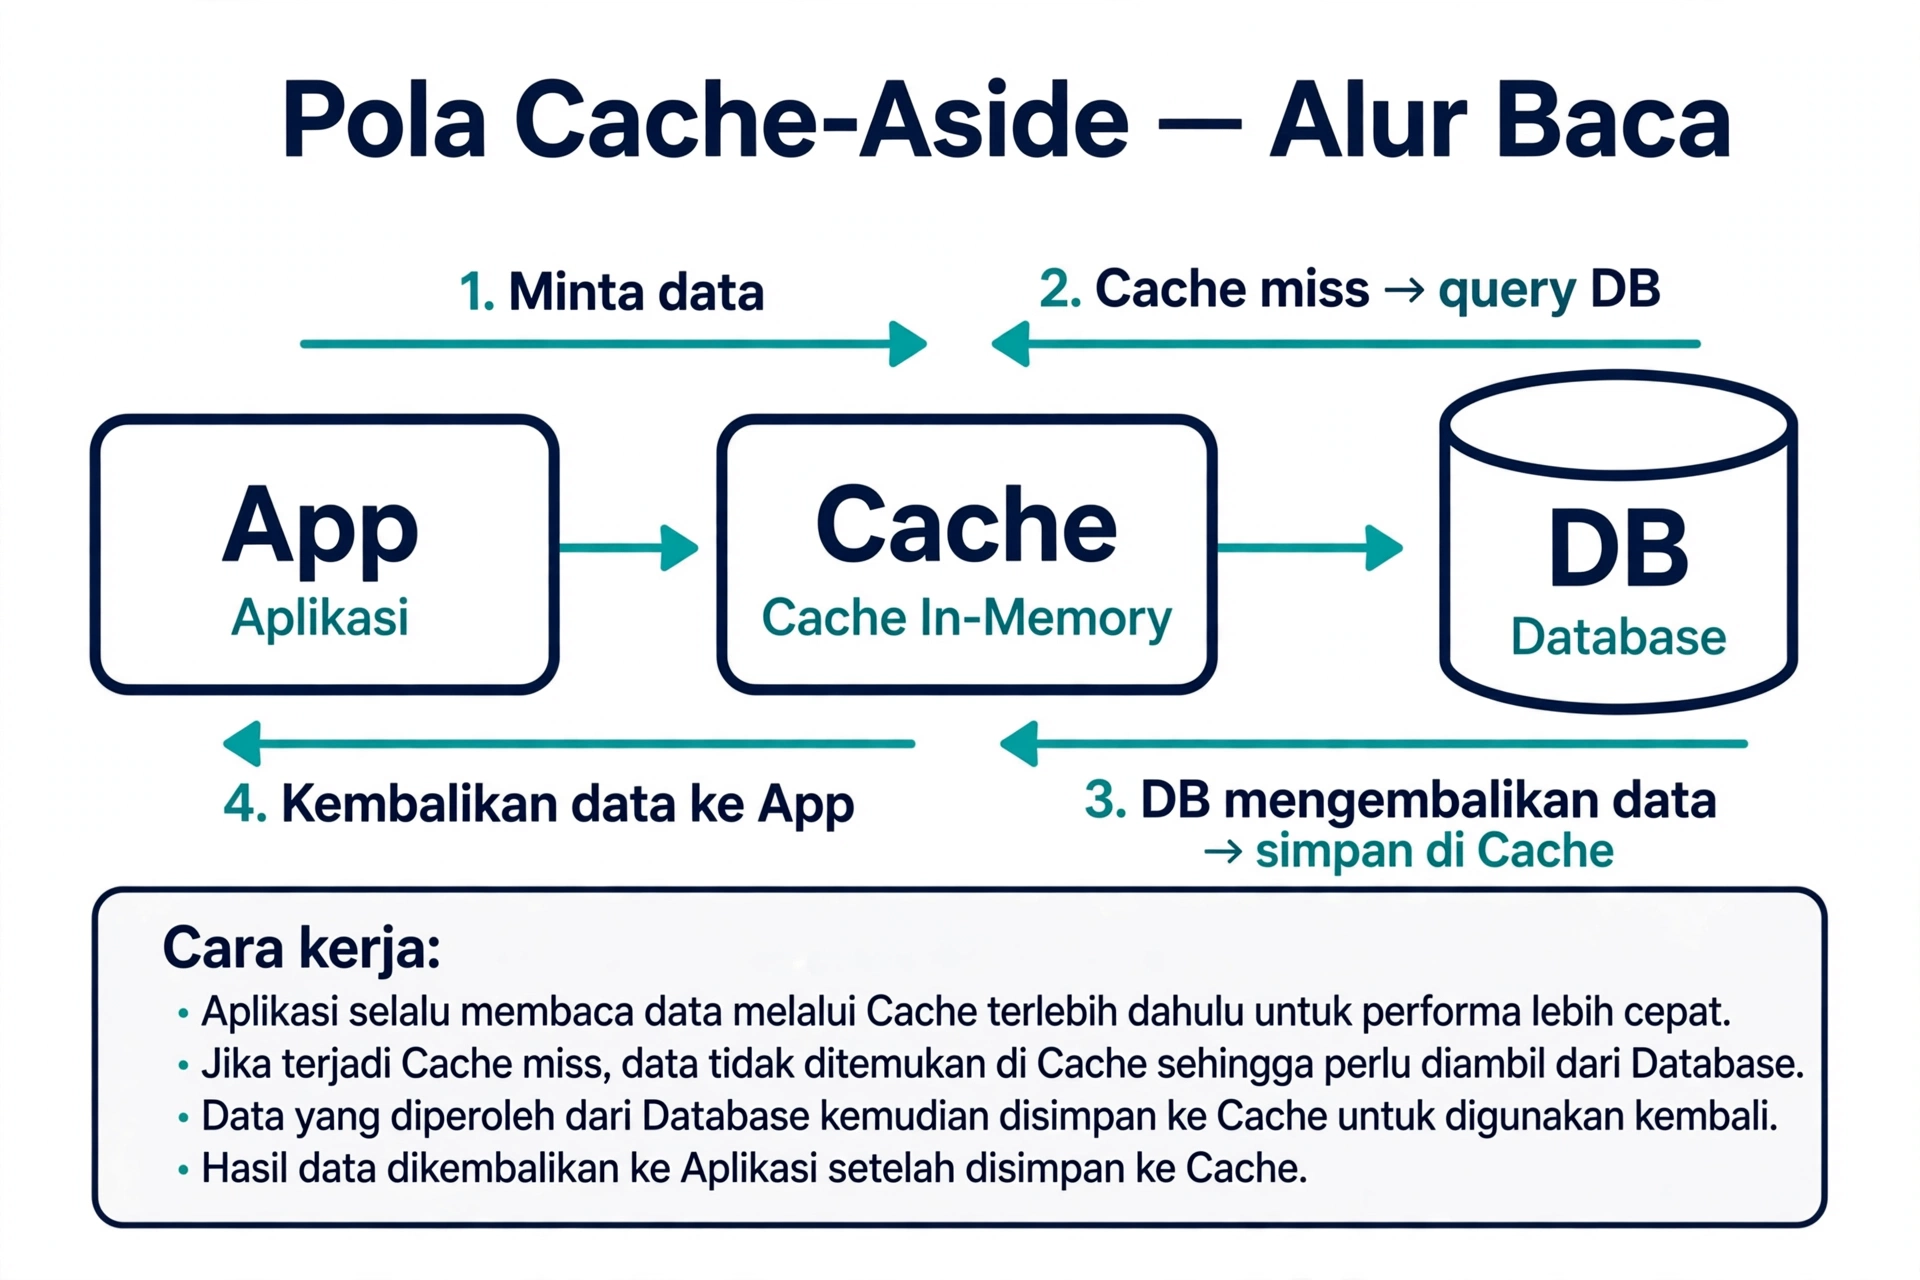
Paling populer dan paling jujur. Aplikasi mengecek cache dulu; kalau miss, ia membaca database lalu menyimpan hasilnya ke cache sebelum mengembalikannya ke pemanggil. Cache tidak tahu-menahu soal database — ia pasif, hanya menjadi tempat titip.
Kelebihannya: hanya data yang benar-benar diminta yang mengisi memori, jadi cache tetap ramping. Kekurangannya: request pertama untuk sebuah key selalu lambat (cold miss), dan kamu harus menangani data basi sendiri lewat TTL atau invalidasi eksplisit. Untuk endpoint baca-berat seperti katalog produk atau profil pengguna, pola ini hampir selalu pilihan pertama.
Read-Through
Mirip cache-aside, tapi logika "isi saat miss" dipindah ke lapisan cache itu sendiri. Aplikasi hanya berbicara ke cache; saat miss, cache yang mengambil data dari database, menyimpannya, lalu mengembalikannya. Pola ini butuh pustaka atau proxy yang mendukung read-through — tidak bisa dibangun murni dari perintah Redis mentah tanpa kode tambahan di sisi aplikasi.
Write-Through
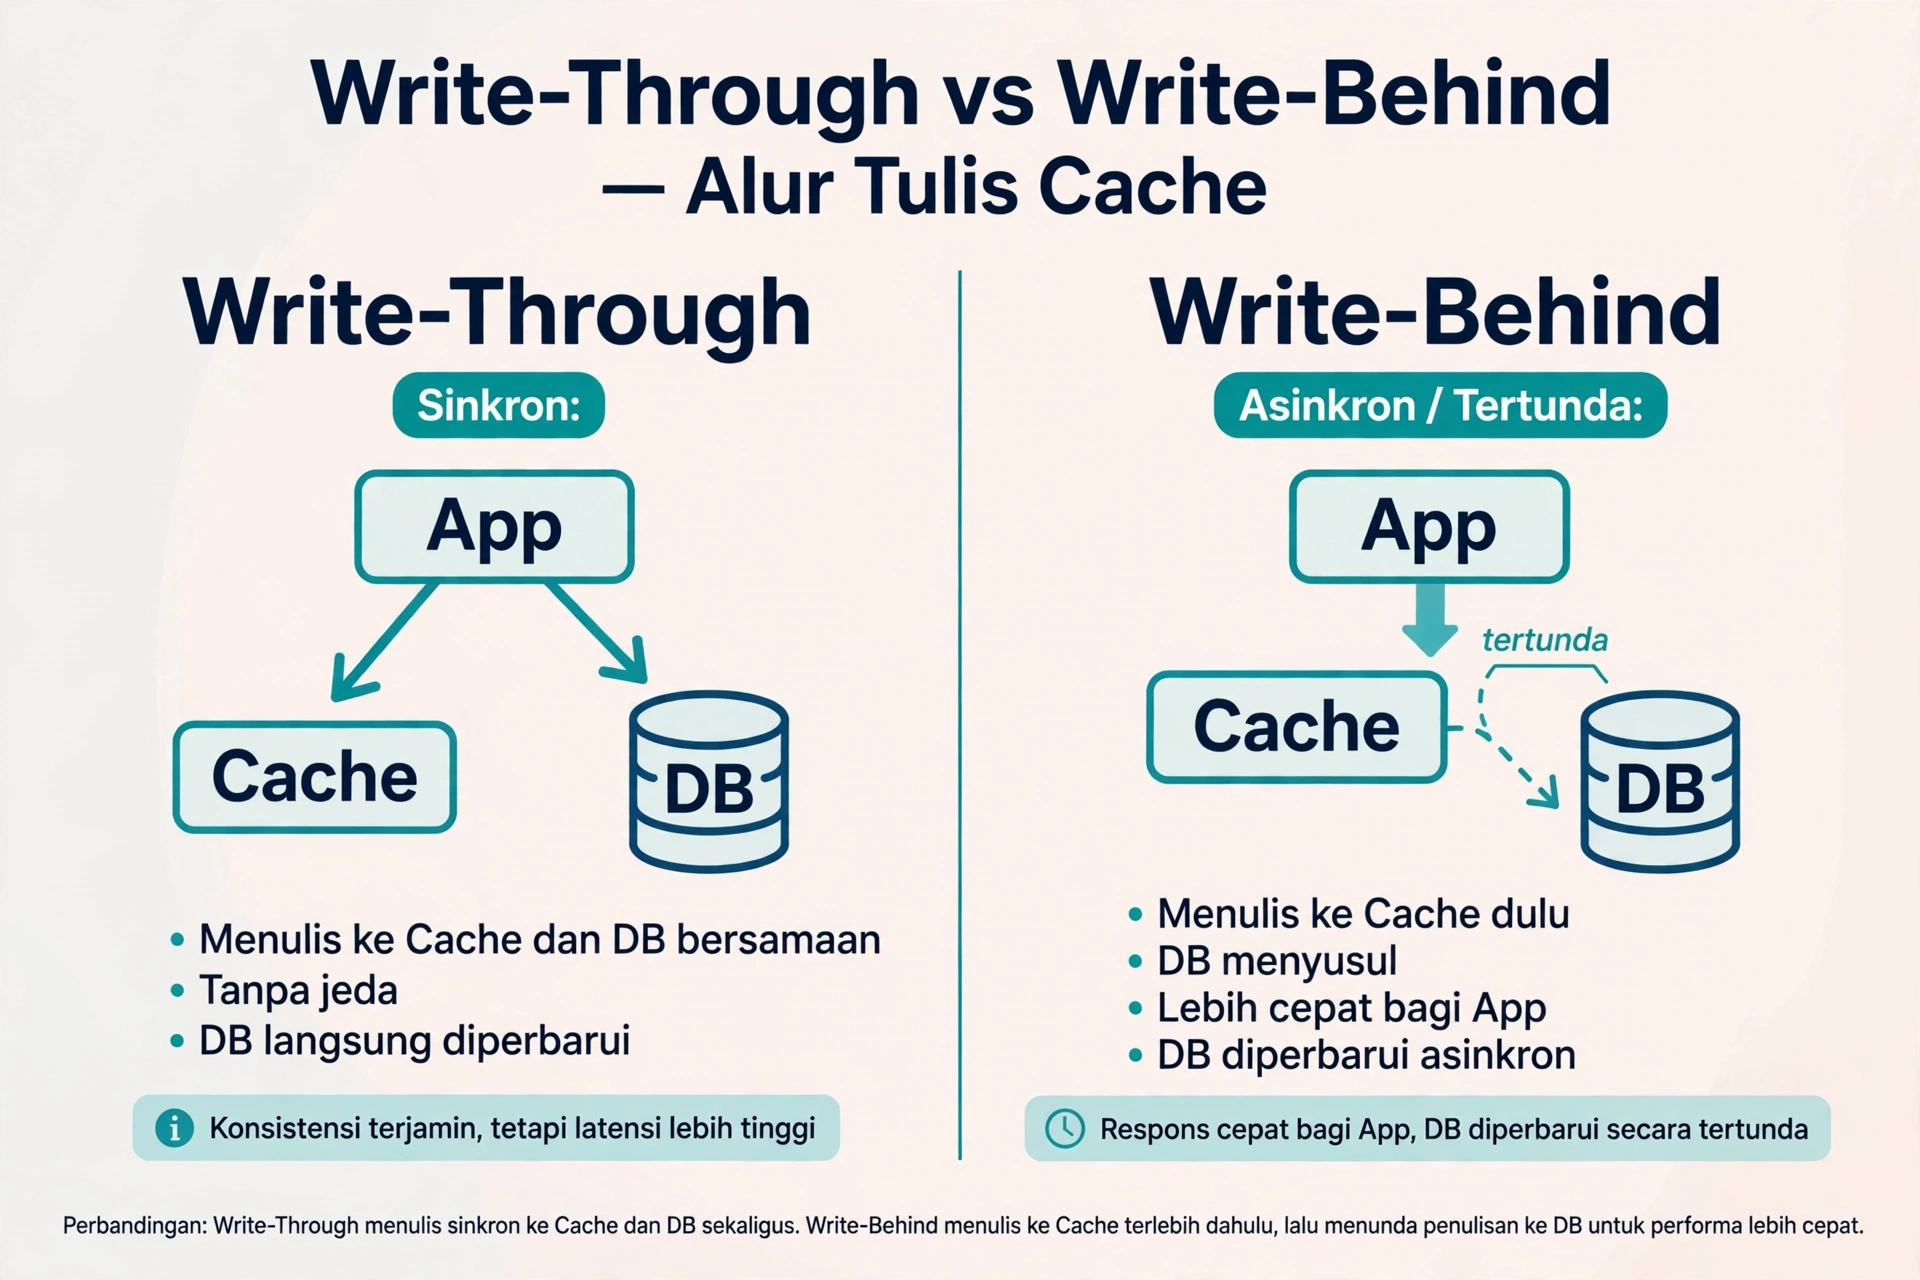
Di sisi tulis, write-through cache menulis ke cache dan database dalam satu operasi sinkron: tulis ke database dulu (atau bersamaan), lalu perbarui cache. Data di cache praktis selalu konsisten dengan database. Harganya adalah latensi tulis yang lebih tinggi, karena setiap write menunggu dua sistem. Cocok untuk data yang jarang berubah tapi wajib akurat, misalnya konfigurasi tarif atau data master.
Write-Behind
Kebalikan dari write-through: aplikasi menulis ke cache dan langsung mengembalikan respons, sementara penulisan ke database diantrekan dan dikerjakan asinkron. Latensi tulis jadi sangat rendah, tapi ada jendela waktu di mana database belum punya data terbaru — kalau node cache crash sebelum flush, data hilang. Hanya pakai pola ini kalau kamu benar-benar paham dan menerima risikonya, misalnya untuk counter analitik atau log aktivitas.
| Strategi | Cara kerja | Cocok untuk | Kelemahan |
|---|---|---|---|
| Cache-Aside | Aplikasi cek cache; saat miss baca DB lalu isi cache | Beban baca tinggi, data dibaca jauh lebih sering daripada ditulis | Cold miss lambat; butuh invalidasi manual |
| Read-Through | Cache mengisi dirinya sendiri dari DB saat miss | Arsitektur terpusat dengan pustaka cache khusus | Butuh dukungan pustaka/proxy; kurang fleksibel |
| Write-Through | Tulis ke cache dan DB sekaligus secara sinkron | Data yang wajib konsisten, jarang berubah | Latensi tulis lebih tinggi |
| Write-Behind | Tulis ke cache, flush ke DB asinkron | Tulis sangat sering, toleran terhadap kehilangan data | Risiko data hilang sebelum flush |
Tutorial: cache-aside dengan Python
Teori tanpa kode cepat menguap. Berikut implementasi cache-aside memakai redis-py — pola cek-cache-dulu yang sama dipakai banyak backend production.
1. Instal pustaka dan buat koneksi.
pip install redis
import json
import random

import redis

client = redis.Redis(host="localhost", port=6379, decode_responses=True)

CACHE_TTL = 300  # TTL dasar 5 menit, dalam detik
2. Tulis fungsi baca dengan pola cek-cache-dulu.
def fetch_product_from_db(product_id: int):
    """Ganti dengan query database aslimu (SQLAlchemy, Django ORM, dsb)."""
    raise NotImplementedError


def get_product(product_id: int):
    """Ambil produk: cek cache dulu, baru ke database saat miss."""
    cache_key = f"product:{product_id}"

    cached = client.get(cache_key)
    if cached is not None:
        return json.loads(cached)  # cache hit

    product = fetch_product_from_db(product_id)  # cache miss
    if product is None:
        return None

    # Simpan ke cache dengan TTL + jitter agar tidak kedaluwarsa serentak
    ttl = CACHE_TTL + random.randint(0, 60)
    client.setex(cache_key, ttl, json.dumps(product))
    return product
Jitter — tambahan acak 0–60 detik — mencegah cache stampede: situasi di mana ratusan key kedaluwarsa bersamaan dan menyerbu database dalam satu gelombang.
3. Invalidasi eksplisit setiap ada tulis.
def save_product_to_db(product_id: int, data: dict):
    """Ganti dengan logika update database aslimu."""
    raise NotImplementedError


def update_product(product_id: int, data: dict) -> None:
    save_product_to_db(product_id, data)
    client.delete(f"product:{product_id}")  # buang versi basi dari cache
Urutan ini penting: tulis ke database dulu, baru hapus cache. Kalau dibalik, ada jendela di mana request lain mengisi ulang cache dengan data lama dari database yang belum terupdate.
4. Isi banyak key sekaligus dengan pipeline.
def warm_cache(products: list) -> None:
    """Pra-isi cache, mis. setelah deploy atau restart."""
    pipe = client.pipeline()
    for product in products:
        key = f"product:{product['id']}"
        ttl = CACHE_TTL + random.randint(0, 60)
        pipe.setex(key, ttl, json.dumps(product))
    pipe.execute()  # satu round-trip untuk semua perintah
Pipeline menggabungkan banyak perintah dalam satu round-trip jaringan — jauh lebih efisien daripada memanggil setex satu per satu dalam loop. Pola ini berguna untuk cache warming setelah deploy, yang bisa kamu otomatiskan di pipeline CI/CD.
Kode di atas valid secara sintaks; yang perlu kamu ganti hanyalah dua fungsi stub database dengan query aslimu.
Invalidasi cache tanpa drama
Menulis ke cache itu mudah. Yang sulit — dan sumber sebagian besar bug caching — adalah memastikan data basi tidak bertahan lebih lama dari seharusnya. Inilah inti dari cache invalidation, dan ada empat pendekatan yang bisa dikombinasikan.
TTL-based
Garis pertahanan pertama sekaligus yang paling sederhana: beri setiap key masa hidup sesuai volatilitas datanya. Harga produk yang berubah tiap jam? TTL 10 menit. Daftar kategori yang berubah tiap rilis? TTL beberapa jam. Aturannya: semakin mahal konsekuensi data basi, semakin pendek TTL-nya.
Event-based invalidation
Menghapus atau memperbarui key tepat saat data berubah. Contoh pada tutorial di atas: update_product menghapus key produk setelah menulis ke database. Untuk key dalam jumlah banyak (misalnya semua key berawalan products:page:), gunakan SCAN dengan pola prefix lalu DEL — jangan memakai KEYS di production karena ia memblokir server saat keyspace besar.
Versioning key
Menghindari penghapusan massal. Alih-alih menghapus, selipkan versi di key: product:42:v3. Saat data berubah, naikkan versi dan tulis key baru; key lama dibiarkan kedaluwarsa sendiri via TTL. Teknik ini rapi untuk data yang diakses lewat satu titik, karena kamu tidak perlu tahu semua key turunan yang harus dibersihkan.
Proteksi stampede
Melengkapi ketiganya. Selain jitter TTL, pola yang umum adalah stale-while-revalidate: biarkan satu worker me-refresh data basi sementara request lain tetap dilayani dari cache lama. Implementasi sederhananya memakai lock Redis (SET key:lock 1 NX EX 30): worker yang mendapat lock me-refresh, yang lain memakai data lama atau menunggu sebentar.
Kesalahan umum dan cara menghindarinya
Meng-cache segalanya tanpa TTL. Godaan terbesar pemula: membungkus semua query dengan cache "biar cepat". Ingat kebijakan default noeviction — saat memori penuh, tulis baru gagal dengan error. Cache hanya untuk data yang mahal dihitung dan sering dibaca. Data yang murah di-query lebih baik tidak di-cache sama sekali.
Penamaan key yang inkonsisten. product_42, products:42, prod-42 untuk hal yang sama adalah undangan bug invalidasi. Tetapkan konvensi sekali — misalnya domain:id:versi — dan patuhi di seluruh codebase. Key yang predictable membuat event-based invalidation dengan prefix jauh lebih mudah.
Menyimpan value raksasa. Redis mengeksekusi perintah secara single-threaded; mengambil value puluhan megabyte memblokir server untuk semua klien lain. Batasi ukuran value (sebagai patokan umum, di bawah 100 KB per key untuk cache), pecah objek besar menjadi hash field, atau kompres sebelum disimpan.
Lupa menyiapkan cold start. Setelah deploy atau restart Redis, cache kosong dan database menerima 100% traffic — persis saat kamu paling tidak ingin ada masalah. Siapkan cache warming untuk key terpanas, atau deploy bertahap agar cache terisi perlahan.
Menganggap cache sebagai sumber kebenaran. Cache boleh hilang kapan saja: eviksi, restart, failover. Aplikasi harus tetap berfungsi (walau lebih lambat) saat cache kosong. Kalau bisnismu rusak karena satu key hilang, itu bukan cache — itu database yang menyamar.
Best practice caching Redis
Kumpulkan semuanya menjadi kebiasaan yang bisa ditempel di wiki tim:
- Tetapkan TTL default per kelas data, bukan per key satu-satu. Contoh: data sesi 30 menit, katalog 10 menit, konfigurasi 1 jam. Dokumentasikan alasannya.
- Gunakan struktur data yang tepat. Hash untuk objek dengan field yang sering diupdate parsial, sorted set untuk leaderboard atau antrean berprioritas, string JSON untuk blob baca-utuh.
- Pisahkan kepentingan. Jangan mencampur cache, sesi, dan antrean job dalam satu database Redis tanpa namespace yang jelas — atau lebih baik, logical database terpisah. Lonjakan di satu fungsi tidak boleh menenggelamkan yang lain.
- Pantau tiga metrik minimal: hit ratio, jumlah eviksi, dan pemakaian memori. Hit ratio yang anjlok setelah deploy biasanya berarti pola key berubah atau warming gagal; eviksi yang melonjak berarti ukuran cache kekecilan atau TTL kepanjangan.
- Gunakan pipeline untuk operasi massal seperti pada contoh
warm_cache— mengurangi round-trip jaringan secara drastis. - Uji perilaku saat Redis mati. Matikan Redis di staging dan pastikan aplikasi fallback ke database dengan graceful degradation, bukan crash berantai.
- Dokumentasikan strategi per endpoint. Untuk endpoint yang mengikuti prinsip desain REST API, catat di samping spesifikasinya: pola apa yang dipakai, TTL berapa, dan key apa yang diinvalidasi saat ada tulis.
Dua referensi yang layak dibaca sampai tuntas: dokumentasi resmi Redis tentang kebijakan eviksi yang menjelaskan perilaku Redis saat memori penuh secara definitif, serta panduan resmi redis-py untuk integrasi Python seperti pada tutorial di artikel ini. Kalau kebutuhanmu merambah ke caching hasil embedding untuk pencarian semantik, baca juga panduan memilih vector database.
FAQ
Berapa TTL yang ideal untuk cache Redis?
Tidak ada angka universal — TTL ideal mengikuti seberapa cepat datamu berubah dan seberapa parah akibat data basi. Titik awal yang aman: 5–10 menit untuk data transaksional seperti stok atau harga, 1–6 jam untuk data referensi seperti kategori, dan 24 jam untuk data yang praktis statis. Ukur hit ratio setelahnya; kalau terlalu rendah, naikkan bertahap.
Kapan memakai write-through dan kapan write-behind?
Pakai write-through cache ketika konsistensi lebih penting daripada kecepatan tulis — data master, konfigurasi tarif, saldo. Pakai write-behind ketika throughput tulis jauh lebih penting dan kamu bisa mentolerir kehilangan data dalam jendela flush — counter analitik, log aktivitas, agregat sementara. Kalau ragu, write-through hampir selalu pilihan yang lebih aman.
Apakah Redis bisa kehilangan data cache?
Bisa, dan kamu harus mendesain dengan asumsi itu. Redis menyimpan data di memori; restart, failover, atau eviksi bisa menghapus key kapan saja. Itulah kenapa cache tidak boleh menjadi satu-satunya salinan data penting — database tetap sumber kebenaran, cache hanya akselerator. Persistence (RDB/AOF) mengurangi risiko, tapi tidak mengubah sifat dasarnya.
Bagaimana cara menangani cache stampede?
Kombinasikan tiga hal: jitter TTL agar key tidak kedaluwarsa serentak, lock sederhana (SET NX EX) supaya hanya satu worker yang me-refresh data basi, dan pola stale-while-revalidate agar request lain tetap dilayani dari data lama selama refresh berlangsung. Untuk key yang sangat panas, pertimbangkan refresh proaktif di background sebelum TTL habis.
Kesimpulan
Caching Redis bukan soal "taruh Redis di depan database lalu berharap cepat" — ia adalah serangkaian keputusan sadar: pola baca apa yang dipakai, strategi tulis apa yang sesuai toleransi risikomu, TTL berapa yang masuk akal, dan bagaimana cache invalidation dijalankan tanpa drama. Cache-aside dengan TTL yang dipikirkan matang dan invalidasi eksplisit saat tulis sudah menyelesaikan sebagian besar kebutuhan backend.
Langkah berikutnya yang konkret: pilih satu endpoint baca-berat di aplikasimu, ukur latensi dan beban databasenya hari ini, terapkan pola cache-aside dari tutorial di atas, lalu bandingkan angkanya setelah seminggu. Data sebelum-sesudah itu lebih meyakinkan daripada teori apa pun.
Bacaan terkait: prinsip desain REST API untuk merancang endpoint yang ramah cache, menjalankan Redis lewat Docker untuk setup lokal, dan pipeline CI/CD untuk mengotomatiskan cache warming tiap deploy.