Panduan asyncio Python: Concurrency Tanpa Thread untuk I/O-bound Workload
Pelajari asyncio Python dari nol: cara kerja event loop, coroutine, dan TaskGroup, plus tutorial membangun HTTP client dan scraper konkuren dengan contoh kode yang bisa dijalankan.
Panji Ihsanudin Fajri
12 min read1 reads
Contents
- Apa itu asyncio?
- Kenapa asyncio penting untuk workload I/O-bound
- Cara kerja asyncio: event loop, coroutine, dan task
- Asyncio vs threading vs multiprocessing
- Tutorial: membangun HTTP client konkuren
- Pola-pola penting: gather, TaskGroup, timeout, Semaphore, dan Queue
- asyncio.gather
- asyncio.TaskGroup (Python 3.11+)
- asyncio.timeout (Python 3.11+)
- asyncio.Semaphore
- asyncio.Queue
- loop.run_in_executor
- Studi kasus: scraper data konkuren
- Kesalahan umum dan cara menghindarinya
- Best practice
- FAQ
- Kesimpulan
Sebagian besar waktu program Python yang memanggil API atau membaca database habis untuk menunggu. CPU menganggur, tapi program tetap lambat karena ia menunggu balasan jaringan satu per satu. asyncio Python mengubah pola itu: satu thread bisa menangani banyak operasi I/O secara bersamaan. Artikel ini membahas event loop Python, coroutine Python, dan pola async await Python, sampai kamu bisa membangun HTTP client dan scraper konkuren sendiri.
Ringkasan:
- asyncio adalah library standar Python untuk konkurensi single-thread berbasis event loop dan sintaks async/await.
- Ia cocok untuk workload I/O-bound seperti request API, scraping, dan query database; tidak cocok untuk komputasi CPU-bound.
- Pola intinya: coroutine + await, asyncio.gather, TaskGroup, timeout, Semaphore, dan Queue.
- Kode blocking harus dipindah ke thread lewat
loop.run_in_executorsupaya tidak membekukan event loop.- Simpan referensi task yang fire-and-forget, batasi konkurensi, dan selalu pasang timeout.
Apa itu asyncio?
asyncio adalah library standar Python untuk menulis kode konkuren dengan sintaks async dan await. Ia berjalan dalam satu thread memakai event loop yang menjadwalkan banyak coroutine secara bergantian, sehingga program bisa menangani ribuan operasi I/O yang sedang menunggu tanpa membuat thread baru.
Unit dasarnya adalah coroutine: fungsi yang didefinisikan dengan async def dan bisa dijeda di titik await. Saat satu coroutine menunggu respons jaringan, event loop tidak ikut menunggu — ia langsung mengerjakan coroutine lain yang sudah siap. Begitu respons datang, coroutine pertama dilanjutkan dari titik ia berhenti.
Penting dipahami: asyncio itu konkuren, bukan paralel. Kode tetap berjalan di satu thread dan satu core CPU dalam satu waktu. Kecepatannya datang dari fakta bahwa operasi I/O tidak butuh CPU — waktu menunggu itulah yang dipakai untuk mengerjakan hal lain. Dokumentasi resminya bisa dibaca di dokumentasi asyncio.
Kenapa asyncio penting untuk workload I/O-bound
Program I/O-bound menghabiskan sebagian besar waktunya menunggu: menunggu respons HTTP, menunggu query database, menunggu file selesai dibaca. Selama menunggu, CPU tidak melakukan apa-apa. Menjalankan operasi-operasi itu berurutan berarti waktu tunggu menumpuk.
Threading bisa menyelesaikan masalah yang sama, tapi mahal untuk skala besar. Setiap thread butuh memori stack sendiri dan context switch antar-thread punya biaya. Menangani sepuluh ribu koneksi sekaligus dengan sepuluh ribu thread bukan ide bagus. asyncio menyelesaikan ini dengan satu event loop yang ringan: puluhan ribu coroutine bisa hidup bersamaan dengan overhead memori yang kecil.
Kasus nyatanya banyak: API gateway yang mengagregasi beberapa layanan, web scraper yang mengambil ratusan halaman, server chat dengan ribuan koneksi persisten, atau microservice yang memanggil banyak API lain sebelum merespons. Kalau kamu juga merancang sisi servernya, pola ini nyambung dengan panduan desain REST API.
Sebaliknya, untuk workload CPU-bound seperti kompresi video atau training model, asyncio tidak membantu. Satu thread tetap satu core, dan GIL mencegah eksekusi Python paralel antar-thread. Untuk itu pakai multiprocessing.
Cara kerja asyncio: event loop, coroutine, dan task
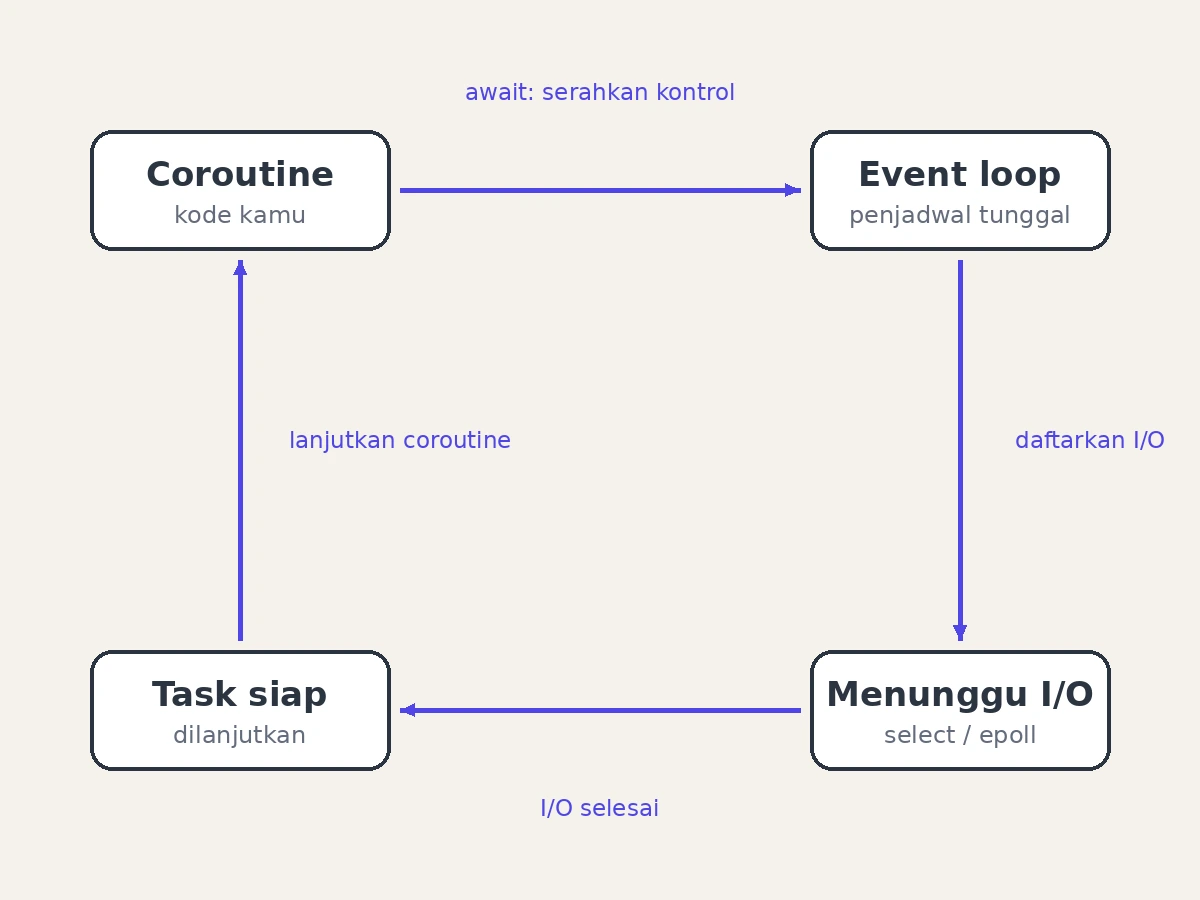
Ada tiga komponen yang harus dipahami, dan ketiganya bekerja bersama. Event loop adalah jantungnya: sebuah loop yang terus memeriksa coroutine mana yang siap dijalankan, menjalankannya sampai ia menyerah di titik await, lalu pindah ke coroutine berikutnya. Ia tidak pernah menganggur selama ada pekerjaan yang bisa dikerjakan.
Coroutine adalah unit pekerjaannya. Kamu menulisnya seperti fungsi biasa, tapi dengan async def, dan memanggilnya dengan await. Titik await adalah janji ke event loop: "saya sedang menunggu, silakan kerjakan yang lain dulu".
Task adalah pembungkus coroutine agar dijadwalkan di event loop. asyncio.create_task() — tersedia sejak Python 3.7 — mengambil coroutine dan mengembalikannya sebagai Task yang langsung dijadwalkan berjalan. Titik masuk yang disarankan untuk program adalah asyncio.run(): ia membuat event loop baru, menjalankan coroutine utama sampai selesai, lalu menutup semuanya dengan rapi.
import asyncio

async def main():
    print("mulai")
    await asyncio.sleep(1)  # menyerah ke event loop selama 1 detik
    print("selesai")

asyncio.run(main())
Perhatikan asyncio.sleep di contoh itu. Ia versi non-blocking dari time.sleep: coroutine dijeda, tapi event loop bebas mengerjakan coroutine lain. Memakai time.sleep di dalam coroutine adalah kesalahan klasik — ia memblokir seluruh event loop.
Perbedaan sekuensial dan konkuren terlihat jelas kalau dibandingkan:
import asyncio
import time

async def kerja(nama, durasi):
    print(f"{nama} mulai")
    await asyncio.sleep(durasi)
    print(f"{nama} selesai")

async def sekuensial():
    mulai = time.perf_counter()
    await kerja("A", 2)
    await kerja("B", 2)
    print(f"sekuensial: {time.perf_counter() - mulai:.1f} detik")

async def konkuren():
    mulai = time.perf_counter()
    t1 = asyncio.create_task(kerja("A", 2))
    t2 = asyncio.create_task(kerja("B", 2))
    await t1
    await t2
    print(f"konkuren: {time.perf_counter() - mulai:.1f} detik")

asyncio.run(sekuensial())
asyncio.run(konkuren())
Versi sekuensial butuh sekitar 4 detik karena A dan B menunggu bergantian. Versi konkuren selesai sekitar 2 detik: kedua task menunggu dalam waktu yang sama.
Asyncio vs threading vs multiprocessing
Tiga model Python concurrency ini sering dipertukarkan, padahal masing-masing punya tempatnya. Tabel ini merangkum perbedaannya:
| Kriteria | asyncio | Threading | Multiprocessing |
|---|---|---|---|
| Model eksekusi | Satu thread, event loop | Banyak thread, dijadwalkan OS | Banyak proses |
| Paling cocok untuk | I/O-bound | I/O-bound dengan library blocking lama | CPU-bound |
| Overhead | Sangat kecil per coroutine | Satu thread butuh stack memori sendiri | Satu proses = salinan memori penuh |
| GIL | Tetap ada, tapi tidak masalah untuk I/O | Menghambat pekerjaan CPU-bound | Tiap proses punya GIL sendiri |
| Berbagi data | Mudah, satu ruang memori | Perlu lock, rawan race condition | Perlu IPC atau serialisasi |
| Tingkat kesulitan | Sedang — harus async dari ujung ke ujung | Sedang — sinkronisasi manual | Tinggi — arsitektur antar-proses |
| Contoh | Server chat, scraper, API gateway | Integrasi library lama yang blocking | Render video, training model |
Aturan praktisnya sederhana. Banyak menunggu jaringan atau disk dan memakai library yang mendukung async? Pakai asyncio. Terpaksa memakai library blocking yang tidak punya versi async (misalnya driver database lama)? Threading masih masuk akal, atau bungkus pemanggilannya dengan run_in_executor. Butuh komputasi berat paralel di banyak core? Multiprocessing jawabannya.
Tutorial: membangun HTTP client konkuren
Bagian ini membangun client yang mengambil banyak URL secara bersamaan. Ikuti langkahnya berurutan — tiap langkah bergantung pada sebelumnya.
Langkah 1 — Siapkan environment dan install httpx. Library standar tidak punya HTTP client async, jadi pakai httpx:
pip install httpx
Langkah 2 — Tulis coroutine fetch. Satu fungsi mengambil satu URL memakai httpx.AsyncClient:
import asyncio
import httpx

async def fetch(client, url):
    r = await client.get(url, timeout=10)
    return url, r.status_code
Langkah 3 — Batasi konkurensi dengan Semaphore. Tanpa batas, ratusan request bersamaan bisa membuat server menolakmu atau koneksimu sendiri kehabisan resource:
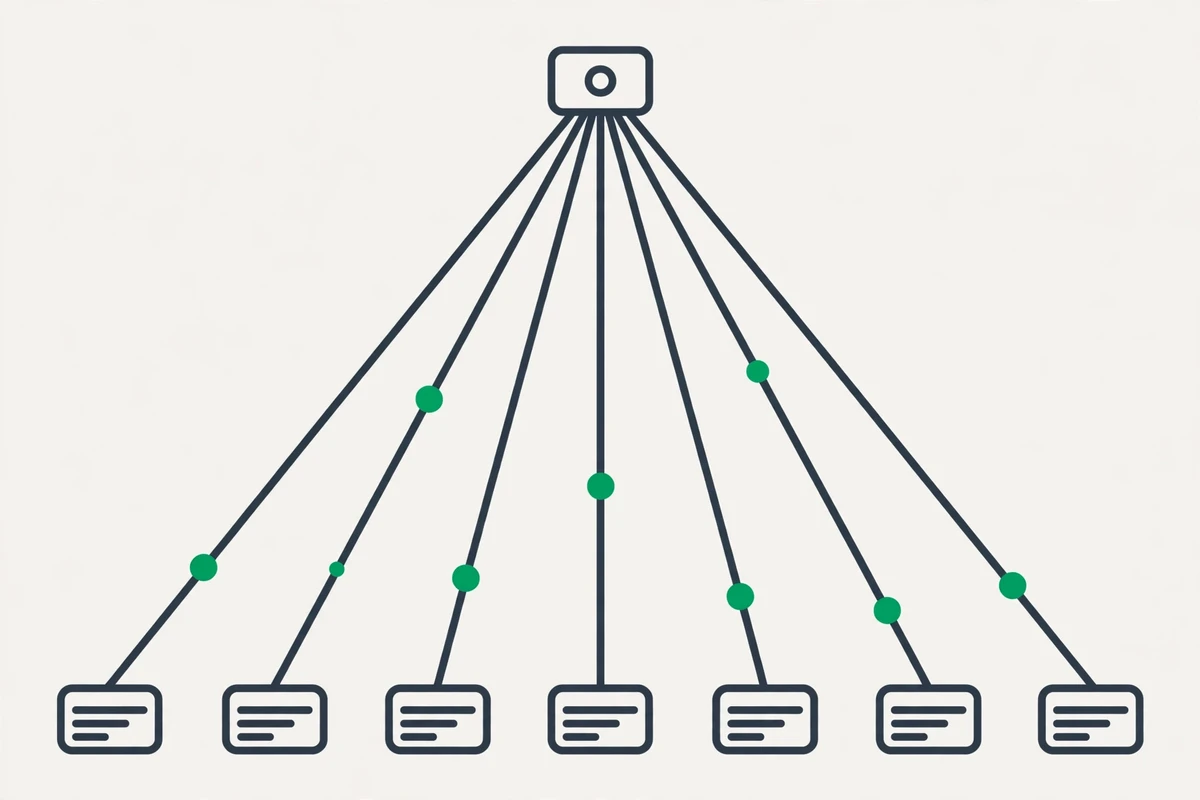
async def fetch_terbatas(client, url, sem):
    async with sem:  # maksimal N request berjalan bersamaan
        r = await client.get(url, timeout=10)
        return url, r.status_code
Langkah 4 — Jalankan semuanya dengan asyncio.gather. Pola asyncio gather mengambil banyak coroutine dan menjalankannya bersamaan, lalu mengembalikan hasilnya berurutan:
URLS = [
    "https://httpbin.org/delay/1",
    "https://httpbin.org/delay/2",
    "https://httpbin.org/delay/1",
]

async def main():
    sem = asyncio.Semaphore(5)
    async with httpx.AsyncClient() as client:
        hasil = await asyncio.gather(
            *(fetch_terbatas(client, u, sem) for u in URLS)
        )
    for url, status in hasil:
        print(url, "->", status)

asyncio.run(main())
Langkah 5 — Uji dan amati. Jalankan dengan python client.py. Ketiga URL di atas total delay-nya 4 detik kalau diambil berurutan, tapi versi konkuren selesai jauh lebih cepat karena waktu tunggu dipakai bersamaan. Pola agregasi seperti ini umum di backend yang menggabungkan beberapa layanan; kalau kamu juga merancang API yang dikonsumsi client semacam ini, lihat panduan desain REST API.
Alternatif httpx untuk scraping berat adalah aiohttp, yang punya fitur session dan connector tuning lebih lengkap.
Pola-pola penting: gather, TaskGroup, timeout, Semaphore, dan Queue
Lima pola ini menutupi sebagian besar kebutuhan asyncio sehari-hari. Referensi lengkapnya ada di coroutines dan tasks.
asyncio.gather
Menjalankan banyak coroutine bersamaan dan mengumpulkan hasilnya. Kalau satu coroutine melempar exception, gather ikut melempar — kecuali kamu set return_exceptions=True, yang membuat exception dikembalikan sebagai objek di daftar hasil.
async def contoh():
    hasil = await asyncio.gather(tugas_a(), tugas_b(), return_exceptions=True)
asyncio.TaskGroup (Python 3.11+)
Pendekatan modern yang lebih aman dari create_task manual. Semua task di dalam group ditunggu saat context manager keluar, dan exception dari beberapa task digabung menjadi satu ExceptionGroup (PEP 654). Syarat: Python 3.11+.
import asyncio

async def unduh(nama):
    await asyncio.sleep(1)
    return f"{nama} selesai"

async def main():  # Python 3.11+
    async with asyncio.TaskGroup() as tg:
        t1 = tg.create_task(unduh("file-a"))
        t2 = tg.create_task(unduh("file-b"))
    print(t1.result(), t2.result())

asyncio.run(main())
asyncio.timeout (Python 3.11+)
Membatasi berapa lama sebuah blok boleh berjalan. Kalau lewat batas, coroutine dibatalkan dan TimeoutError di-raise. Syarat: Python 3.11+. Untuk versi lama, padanannya adalah asyncio.wait_for.
async def main():  # Python 3.11+
    try:
        async with asyncio.timeout(2):
            await operasi_yang_lama()
    except TimeoutError:
        print("melebihi batas 2 detik, dibatalkan")
asyncio.Semaphore
Membatasi berapa banyak coroutine boleh masuk ke bagian kritis dalam satu waktu. Pola standar untuk membatasi request HTTP bersamaan atau koneksi database.
sem = asyncio.Semaphore(5)

async def akses_terbatas():
    async with sem:
        await panggil_api()
asyncio.Queue
Saluran komunikasi antar-coroutine dengan pola producer-consumer. Producer memasukkan item, consumer mengambilnya. await queue.join() menunggu sampai semua item selesai diproses.
import asyncio

async def produser(queue):
    for i in range(5):
        await queue.put(i)
    await queue.put(None)  # sinyal selesai

async def konsumen(queue):
    while True:
        item = await queue.get()
        if item is None:
            queue.task_done()
            break
        print(f"konsumsi: {item}")
        queue.task_done()

async def main():
    queue = asyncio.Queue()
    await asyncio.gather(produser(queue), konsumen(queue))
    await queue.join()

asyncio.run(main())
loop.run_in_executor
Jalan keluar saat terpaksa memanggil kode blocking — fungsi sync pihak ketiga, komputasi kecil, atau operasi file berat — dari dalam coroutine. Kode dijalankan di thread pool terpisah sehingga event loop tidak beku.
import asyncio
import time

def kerja_blocking():
    time.sleep(2)  # simulasi fungsi blocking
    return "hasil blocking"

async def main():
    loop = asyncio.get_running_loop()
    hasil = await loop.run_in_executor(None, kerja_blocking)
    print(hasil)

asyncio.run(main())
Studi kasus: scraper data konkuren
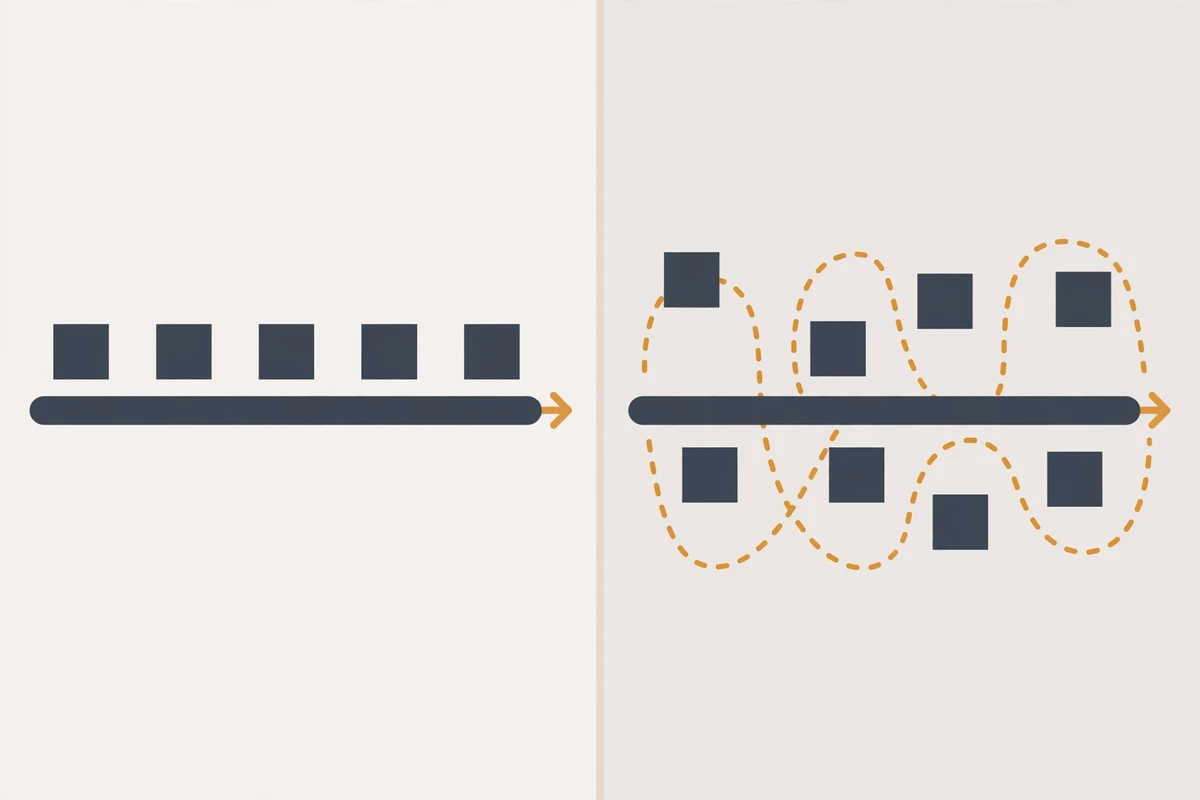
Bayangkan kamu perlu mengambil 10 halaman katalog produk untuk analisis harga. Versi sinkron memakai httpx.Client biasa dan menunggu tiap respons satu per satu. Versi async memakai httpx.AsyncClient dengan gather dan mengambil semuanya bersamaan.
import asyncio
import httpx
import time

TARGETS = ["https://httpbin.org/delay/1"] * 10

def scrape_sync():
    mulai = time.perf_counter()
    with httpx.Client() as client:
        for url in TARGETS:
            client.get(url, timeout=10)
    return time.perf_counter() - mulai

async def scrape_async():
    mulai = time.perf_counter()
    sem = asyncio.Semaphore(5)
    async def ambil(client, url):
        async with sem:
            await client.get(url, timeout=10)
    async with httpx.AsyncClient() as client:
        await asyncio.gather(*(ambil(client, u) for u in TARGETS))
    return time.perf_counter() - mulai

print(f"sync : {scrape_sync():.1f} detik")
print(f"async: {asyncio.run(scrape_async()):.1f} detik")
Skala waktunya beda jauh: versi sinkron menunggu 10 detik penuh, versi async menyelesaikan 10 request dalam waktu yang tumpang tindih. Di scraper nyata, tambahkan tiga hal: Semaphore seperti di atas supaya tidak kena rate limit, timeout di tiap request, dan retry dengan backoff untuk request yang gagal.
Kalau scraper ini mau jalan terjadwal di server, kemas jadi container supaya environment-nya konsisten — caranya dibahas di panduan Docker untuk developer.
Kesalahan umum dan cara menghindarinya
Memanggil fungsi blocking di dalam coroutine. time.sleep, requests.get, atau query database sync akan membekukan seluruh event loop — semua coroutine ikut berhenti. Solusinya: pakai padanan async-nya, atau bungkus dengan loop.run_in_executor.
Task fire-and-forget tanpa referensi. Event loop hanya menyimpan weak reference ke task. Kalau kamu memanggil asyncio.create_task() tanpa menyimpan hasilnya dan tidak meng-await, task bisa di-garbage collect di tengah jalan. Simpan referensinya dalam set, atau lebih baik pakai TaskGroup.
# SALAH: referensi hilang, task bisa mati diam-diam
asyncio.create_task(kirim_notifikasi())

# BENAR: simpan referensi
background = {asyncio.create_task(kirim_notifikasi())}
Membuat event loop manual tanpa perlu. asyncio.get_event_loop() dan loop.run_until_complete() adalah pola lama yang rawan salah — loop tidak tertutup, warning berserakan. Untuk program biasa, asyncio.run() sudah menangani pembuatan dan penutupan loop.
Konkurensi tanpa batas. gather atas 10.000 URL tanpa Semaphore sama dengan serangan DDoS ke server orang — dan ke koneksi internetmu sendiri. Selalu batasi dengan Semaphore dan hormati rate limit.
Exception hilang di gather. Secara default, satu coroutine gagal berarti gather melempar dan hasil lain ikut hilang. Putuskan strateginya di awal: return_exceptions=True kalau tiap tugas boleh gagal sendiri-sendiri, atau TaskGroup kalau kegagalan satu task memang harus membatalkan semuanya.
Tidak memasang timeout. Request yang gantung selamanya membuat task tidak pernah selesai dan menumpuk. Pasang asyncio.timeout di setiap operasi jaringan.
Best practice
Tulis kode async dari ujung ke ujung. Mencampur fungsi sync dan async secara acak membuat alur sulit diikuti dan rawan blocking tersembunyi. Kalau sebuah fungsi memanggil coroutine, ia sendiri harus jadi coroutine.
Jaga coroutine tetap kecil dan fokus pada satu tanggung jawab. Coroutine raksasa yang melakukan fetch, parsing, dan penyimpanan sekaligus sulit diuji dan sulit dipakai ulang. Prinsip ini berlaku lintas bahasa — versi TypeScript-nya dibahas di best practice TypeScript.
Selalu pasang timeout di operasi jaringan, selalu batasi konkurensi dengan Semaphore, dan pakai TaskGroup untuk structured concurrency supaya tidak ada task yatim yang berjalan tanpa pengawasan. Untuk kode blocking yang tidak bisa dihindari, isolasi lewat run_in_executor dan beri nama jelas supaya terlihat di code review.
Terakhir, uji perilakunya, bukan cuma hasil akhirnya. Tulis skenario untuk timeout, untuk satu task yang gagal di tengah gather, dan untuk shutdown saat task masih berjalan. Otomatiskan pengujian itu di pipeline — polanya dibahas di panduan pipeline CI/CD.
FAQ
Apakah asyncio membuat program selalu lebih cepat? Tidak. asyncio mempercepat program yang banyak menunggu I/O, karena waktu tunggu dipakai untuk kerja lain. Untuk komputasi CPU-bound tidak ada bedanya — bahkan sedikit overhead dari event loop. Ukur dulu di mana bottleneck-mu sebelum memilih.
Kapan memakai asyncio dibanding threading?
Pakai asyncio kalau library yang kamu pakai punya versi async (httpx, aiohttp, asyncpg) dan kamu butuh ribuan operasi bersamaan dengan overhead kecil. Pakai threading kalau terpaksa memakai library blocking lama yang tidak punya padanan async — atau bungkus panggilannya dengan run_in_executor.
Kenapa coroutine saya tidak berjalan bersamaan?
Penyebab paling umum: ada panggilan blocking di dalamnya (misalnya time.sleep alih-alih await asyncio.sleep), atau kamu lupa await sehingga coroutine tidak pernah dijadwalkan. Penyebab lain: task dibuat dengan create_task tapi referensinya langsung hilang.
Library apa yang umum dipakai dengan asyncio? Untuk HTTP: httpx dan aiohttp. Untuk database: asyncpg (PostgreSQL) dan aiomysql. Untuk web framework: FastAPI dan Starlette dibangun di atas asyncio. Untuk testing, cari runner yang mendukung coroutine — pytest punya plugin async yang populer.
Apakah asyncio cocok untuk pekerjaan CPU-bound? Tidak. GIL membuat bytecode Python hanya berjalan di satu thread dalam satu waktu, jadi komputasi berat tidak terbagi. Untuk CPU-bound pakai multiprocessing — tiap proses punya interpreter dan GIL sendiri — atau pindahkan komputasi ke library native seperti NumPy yang melepas GIL.
Kesimpulan
asyncio adalah cara Python menangani banyak pekerjaan I/O secara bersamaan dalam satu thread: event loop menjadwalkan coroutine, await menjadi titik serah terima, dan pola seperti gather, TaskGroup, Semaphore, serta timeout menjaga semuanya tetap terkendali. Ia bukan pengganti threading atau multiprocessing — ia alat khusus untuk workload yang banyak menunggu.
Langkah berikutnya yang paling masuk akal: ambil satu skrip di proyekmu yang memanggil API berurutan, tulis ulang dengan pola dari tutorial di atas, dan ukur bedanya. Setelah itu, bungkus dalam pengujian otomatis lewat panduan pipeline CI/CD supaya perilakunya — termasuk timeout dan kegagalan parsial — terjaga setiap kali kode berubah.