Panduan Index PostgreSQL: B-tree, GIN, dan Cara Mempercepat Query
Panduan praktis index PostgreSQL: pilih jenis index yang tepat, pahami composite, partial, dan covering index, dan buktikan hasilnya dengan EXPLAIN ANALYZE.
Panji Ihsanudin Fajri
19 min read0 reads
Contents
- Apa itu index PostgreSQL?
- Kenapa index mempercepat query (dan kapan tidak)
- Jenis-jenis index PostgreSQL
- B-tree: default yang menutupi sebagian besar kasus
- Hash: hanya untuk equality
- GiST dan SP-GiST: data multidimensi dan terpartisi
- GIN: satu baris, banyak nilai yang bisa dicari
- BRIN: ringkasan, bukan entri per baris
- Cara kerja B-tree dan composite index
- Index lanjutan: partial, expression, dan covering
- Partial index: index hanya untuk subset baris
- Expression index: index atas hasil fungsi
- Covering index: jawab query dari index saja
- Tutorial: mengukur dan menambahkan index dengan EXPLAIN ANALYZE
- Langkah 1: buat tabel contoh dan isi data
- Langkah 2: ukur sebelum ada index
- Langkah 3: buat index tanpa memblokir tulis
- Langkah 4: ukur lagi dan bandingkan
- Langkah 5: uji query yang memakai kolom kedua
- Contoh nyata: tiga pola query, tiga index berbeda
- Pola 1: daftar pesanan per pelanggan, terbaru dulu
- Pola 2: pencarian di dalam metadata JSONB
- Pola 3: laporan atas tabel log yang sangat besar
- Kesalahan umum dan cara menghindarinya
- Merawat index yang sudah ada
- Best practice index PostgreSQL
- FAQ
- Apakah primary key otomatis membuat index di PostgreSQL?
- Berapa banyak index yang boleh dimiliki satu tabel?
- Kenapa query saya tetap sequential scan padahal index sudah ada?
- Apakah index memperlambat INSERT dan UPDATE?
- Kapan memakai GIN dan kapan memakai B-tree untuk kolom JSONB?
- Kesimpulan
Query yang lambat jarang disebabkan oleh PostgreSQL yang "lemot". Lebih sering, penyebabnya sederhana: database harus membaca seluruh tabel untuk menemukan segelintir baris yang kamu minta. Index PostgreSQL adalah struktur data tambahan yang dibuat untuk satu masalah itu: menemukan baris yang tepat tanpa memindai semua baris.
Artikel ini membahas index PostgreSQL dari dasar sampai praktik: apa itu index, enam jenis index bawaan dan kapan masing-masing dipakai, cara kerja B-tree dan composite index, index lanjutan seperti partial dan covering index, sampai cara membuktikan perbaikan dengan EXPLAIN ANALYZE. Semua contoh memakai SQL standar yang bisa kamu jalankan di database PostgreSQL sendiri.
Ringkasan:
- Index adalah struktur terpisah dari tabel yang memetakan nilai kolom ke baris, sehingga query selektif tidak perlu sequential scan.
- B-tree adalah default dan jawaban untuk sebagian besar query: equality, range, dan ORDER BY.
- GIN untuk JSONB, array, dan full-text search; GiST untuk geometri dan range; BRIN untuk tabel besar yang terurut secara alami.
- Composite index hanya efektif bila query memakai kolom paling kiri; partial dan covering index mengecilkan ukuran dan biaya perawatan.
- Selalu ukur sebelum dan sesudah dengan EXPLAIN ANALYZE, bukan asumsi.
Apa itu index PostgreSQL?
Index PostgreSQL adalah struktur data terpisah yang menyimpan salinan nilai dari satu kolom atau lebih, terurut atau terorganisasi sedemikian rupa sehingga PostgreSQL bisa menemukan baris yang cocok dengan cepat. Index tidak mengubah isi tabel; ia hanya memberi jalan pintas menuju baris yang dicari.
Analogi yang paling dekat adalah indeks di belakang buku. Tanpa indeks, kamu harus membaca halaman demi halaman untuk menemukan satu istilah. Dengan indeks, kamu langsung tahu halaman mana yang memuat istilah itu. PostgreSQL bekerja dengan cara yang sama: tanpa index, planner memilih sequential scan dan membaca semua baris; dengan index yang cocok, planner bisa memilih index scan dan hanya menyentuh baris yang relevan.
Satu hal yang sering disalahpahami: index bukan sihir yang membuat semua query cepat. Index hanya membantu bila query kamu selektif, yaitu hanya butuh sebagian kecil baris dari tabel. Query yang memang harus mengembalikan setengah tabel biasanya tetap lebih cepat lewat sequential scan, karena membaca berurutan lebih murah daripada melompat-lompat lewat index. Planner PostgreSQL memutuskan ini berdasarkan statistik tabel, jadi menjalankan ANALYZE secara berkala adalah bagian dari pekerjaan indexing yang sering dilupakan.
Kenapa index mempercepat query (dan kapan tidak)
Bayangkan tabel orders dengan sepuluh juta baris. Query WHERE customer_id = 42 tanpa index memaksa PostgreSQL memeriksa kesepuluh juta baris itu, satu per satu. Dengan index pada customer_id, PostgreSQL mencari nilai 42 di struktur index, mendapatkan daftar penunjuk baris, lalu hanya mengambil baris-baris itu dari tabel. Pekerjaan yang tadinya sebanding dengan ukuran tabel menjadi sebanding dengan jumlah baris hasil.
Index juga membantu di luar filter WHERE. Index B-tree menyimpan entri dalam urutan terurut, sehingga query dengan ORDER BY pada kolom terindeks bisa dibaca langsung dalam urutan itu tanpa langkah sort tambahan. Kombinasi ORDER BY ... LIMIT adalah kasus paling menguntungkan: dengan index yang cocok, PostgreSQL bisa berhenti setelah menemukan N baris pertama tanpa memproses sisa tabel.
Tapi setiap index punya harga. Setiap INSERT, UPDATE, dan DELETE pada tabel harus memperbarui semua index-nya juga. Tabel dengan delapan index akan menulis delapan struktur tambahan setiap kali satu baris berubah. Index juga memakan ruang disk, dan index yang tidak pernah dipakai adalah beban murni: memperlambat tulis tanpa pernah mempercepat baca. Karena itu aturan praktisnya bukan "index semua kolom", melainkan "index kolom yang benar-benar dipakai query yang lambat".
Ada satu pengecualian penting untuk aturan harga ini: index yang menegakkan keunikan. Primary key dan unique constraint di PostgreSQL secara otomatis membuat index di belakang layar, dan index itu adalah mekanisme yang menegakkan constraint tersebut. Jangan membuat index manual kedua pada kolom yang sama, karena kamu hanya menggandakan pekerjaan tanpa manfaat.
Terakhir, index bukan pengganti caching. Kalau query yang sama dieksekusi ribuan kali per detik dengan hasil yang jarang berubah, lapisan cache di atas database sering kali memberi dampak lebih besar daripada index tambahan. Artikel tentang strategi caching dengan Redis membahas kapan cache adalah jawaban yang tepat dan kapan database-lah yang harus diperbaiki.
Jenis-jenis index PostgreSQL
PostgreSQL menyediakan enam jenis index bawaan. Tabel berikut merangkum masing-masing jenis, lalu setiap jenis dibahas satu per satu.
| Jenis | Paling cocok untuk | Batasan utama |
|---|---|---|
| B-tree | Equality, range, ORDER BY pada kolom biasa | Tidak cocok untuk pencarian di dalam JSONB atau array |
| Hash | Equality saja (=) |
Tidak bisa range, tidak bisa ORDER BY |
| GiST | Geometri, tipe range, nearest-neighbor | Lebih kompleks, ukuran cenderung besar |
| SP-GiST | Data terpartisi ruang, hierarki, prefix | Kasus khusus, bukan pilihan umum |
| GIN | JSONB, array, full-text search | Ukuran besar, biaya tulis lebih tinggi |
| BRIN | Tabel sangat besar yang terurut alami (time-series, log) | Hanya efektif bila nilai berkorelasi dengan urutan fisik baris |
B-tree: default yang menutupi sebagian besar kasus
B-tree adalah jenis index yang dibuat CREATE INDEX bila kamu tidak menyebut USING. Ia menyimpan entri dalam struktur tree yang seimbang dan terurut, sehingga mendukung operator =, <, >, BETWEEN, IS NULL, dan ORDER BY. Untuk kolom angka, tanggal, UUID, dan teks biasa, mulailah dari B-tree dan hanya pindah ke jenis lain bila ada alasan konkret.
Hash: hanya untuk equality
Hash index hanya mendukung perbandingan = dan tidak bisa membantu range query maupun sorting. Dalam praktik modern, keunggulannya atas B-tree untuk equality murni sangat kecil, sementara keterbatasannya besar. Anggap hash sebagai pilihan khusus, bukan alternatif sehari-hari untuk B-tree.
GiST dan SP-GiST: data multidimensi dan terpartisi
GiST (Generalized Search Tree) adalah kerangka untuk tipe data yang tidak bisa diurutkan dalam satu dimensi: geometri PostGIS, tipe range, dan pencarian tetangga terdekat. SP-GiST mempartisi ruang index menjadi wilayah yang tidak tumpang tindih, cocok untuk struktur seperti trie dan data hierarkis. Kecuali kamu bekerja dengan data spasial atau range, kedua jenis ini jarang kamu sentuh langsung.
GIN: satu baris, banyak nilai yang bisa dicari
GIN (Generalized Inverted Index) membalik cara pandang index: satu baris bisa punya banyak nilai yang bisa dicari, misalnya elemen-elemen array, kunci-kunci di dalam dokumen JSONB, atau kata-kata di dalam dokumen teks. Setiap komponen mendapat entrinya sendiri, sehingga query seperti "dokumen JSONB mana yang mengandung kunci ini" atau "array mana yang mengandung elemen ini" bisa dijawab tanpa memindai semua dokumen. Harga yang dibayar adalah ukuran index yang besar dan biaya tulis yang lebih tinggi dibanding B-tree.
BRIN: ringkasan, bukan entri per baris
BRIN (Block Range Index) tidak menyimpan satu entri per baris. Ia menyimpan ringkasan, misalnya nilai minimum dan maksimum, untuk setiap rentang blok tabel. Untuk tabel time-series yang barisnya tersimpan berurutan berdasarkan waktu, BRIN bisa sangat kecil, jauh lebih kecil daripada B-tree, sambil tetap memangkas sebagian besar blok yang tidak relevan. Syaratnya keras: bila nilai kolom tidak berkorelasi dengan urutan fisik baris, BRIN tidak bisa memangkas apa pun dan menjadi tidak berguna. Periksa korelasi lewat pg_stats.correlation sebelum memilih BRIN.
Cara kerja B-tree dan composite index
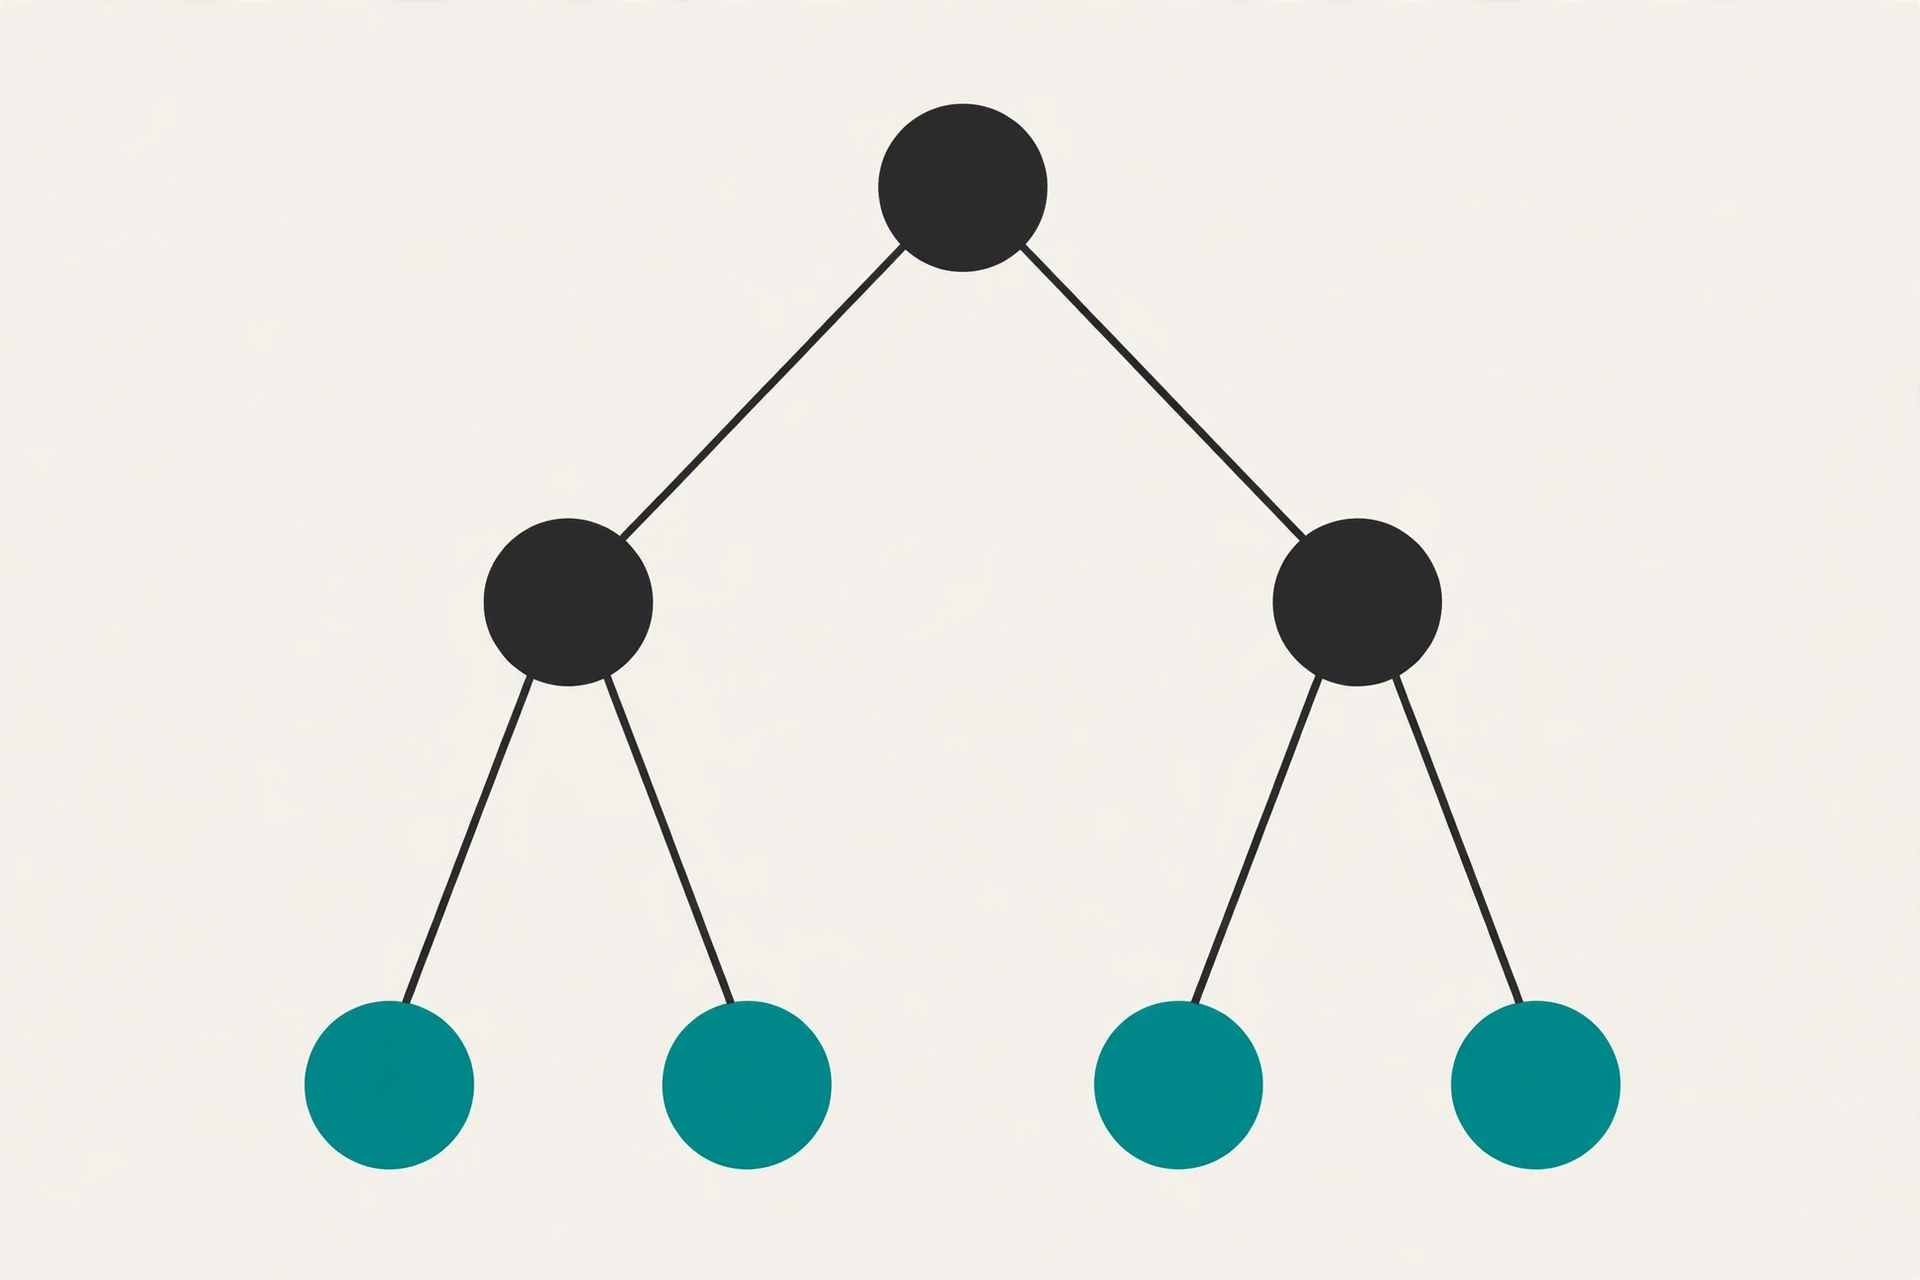
B-tree menyimpan entri dalam urutan terurut di dalam tree yang seimbang. "Seimbang" di sini berarti semua daun berada pada kedalaman yang sama, sehingga pencarian nilai apa pun menempuh jumlah langkah yang kira-kira sama: turun dari akar, lewat beberapa simpul internal, sampai ke daun yang memuat nilai itu. Karena entri terurut, mencari rentang nilai berarti menemukan batas bawah rentang, lalu berjalan menyamping sampai batas atas. Inilah alasan B-tree menangani BETWEEN dan ORDER BY dengan alami.
Composite index, atau multicolumn index, adalah B-tree yang kuncinya terdiri dari beberapa kolom sekaligus, misalnya (customer_id, created_at). Urutan kolom di sini adalah keputusan desain, bukan detail kosmetik. PostgreSQL bisa memakai index ini untuk query yang memfilter customer_id saja, atau customer_id dan created_at bersamaan, tetapi tidak bisa memakainya secara efisien untuk query yang hanya memfilter created_at. Aturannya disebut leftmost prefix: index hanya bisa dipakai dari kolom paling kiri ke kanan, tanpa melompati kolom.
Contoh konkret: index (customer_id, created_at) membantu tiga pola query berikut secara berbeda.
-- Memakai index: kolom paling kiri terisi
SELECT * FROM orders WHERE customer_id = 42;

-- Memakai index: kedua kolom terisi
SELECT * FROM orders
WHERE customer_id = 42 AND created_at >= '2026-01-01';

-- Tidak memakai index secara efisien: kolom kiri tidak ada di filter
SELECT * FROM orders WHERE created_at >= '2026-01-01';
Kasus ketiga membutuhkan index terpisah pada created_at, atau index dengan urutan kolom dibalik, tergantung pola query mana yang lebih sering. Satu hal lagi yang perlu diketahui: hanya B-tree, GiST, GIN, dan BRIN yang mendukung multicolumn index, dan total kolom termasuk kolom INCLUDE dibatasi 32. Bila kamu mencapai batas itu, desain index-mu hampir pasti sudah terlalu lebar.
Urutan sort di dalam index juga bisa diatur. Secara default B-tree menyimpan entri ascending dengan nulls last, sehingga ORDER BY x ASC bisa dipenuhi langsung dari index. Kamu bisa membuat index DESC bila query dominan mengurut menurun, misalnya daftar pesanan terbaru. Perlu diingat pula bahwa hanya B-tree yang bisa menghasilkan output terurut; jenis index lain mengembalikan baris dalam urutan yang tidak ditentukan, sehingga jangan mengandalkan urutan hasil dari GIN atau BRIN.
Index lanjutan: partial, expression, dan covering
Setelah B-tree dasar dan composite index, tiga varian berikut adalah alat yang paling sering mengubah hasil dari "cukup cepat" menjadi "tepat sasaran".
Partial index: index hanya untuk subset baris
Partial index menambahkan klausa WHERE pada definisi index, sehingga index hanya memuat baris yang memenuhi predikat itu. Pola klasiknya adalah pesanan yang masih aktif, atau pengguna yang belum dihapus.
CREATE INDEX idx_orders_active
ON orders (customer_id)
WHERE status = 'active';
Index ini jauh lebih kecil daripada index penuh pada kolom yang sama, dan query dengan filter status = 'active' yang sama persis bisa memakainya. Kata kuncinya adalah "sama persis": predikat query harus mengimplikasikan predikat index, kalau tidak planner tidak akan memilihnya. Partial index yang predikatnya tidak pernah cocok dengan query nyata adalah index yang tidak pernah dipakai.
Expression index: index atas hasil fungsi
Kadang query tidak memfilter kolom mentah, melainkan hasil fungsi atas kolom itu, misalnya pencarian case-insensitive dengan lower(email). Index biasa pada email tidak membantu query seperti itu, karena nilai yang dicari adalah hasil fungsi, bukan nilai mentah. Expression index menyimpan hasil fungsi tersebut.
CREATE INDEX idx_users_email_lower
ON users ((lower(email)));
Perhatikan tanda kurung ganda: itu wajib dalam sintaks expression index. Syarat lainnya: fungsi harus immutable, artinya untuk input yang sama selalu menghasilkan output yang sama, dan query harus memakai ekspresi yang persis sama dengan yang ada di index. WHERE lower(email) = 'a@b.com' memakai index di atas; WHERE email = 'a@b.com' tidak.
Covering index: jawab query dari index saja
Bila semua kolom yang dibutuhkan query sudah ada di dalam index, PostgreSQL bisa menjawab query tanpa menyentuh tabel sama sekali. Ini disebut index-only scan. Klausa INCLUDE menambahkan kolom payload ke index tanpa menjadikannya bagian dari kunci pencarian.
CREATE INDEX idx_orders_customer_covering
ON orders (customer_id)
INCLUDE (total, status);
Query SELECT total, status FROM orders WHERE customer_id = 42 kini bisa dijawab sepenuhnya dari index. Manfaatnya nyata untuk query yang sering dieksekusi dan hanya butuh sedikit kolom. Kerugiannya juga nyata: kolom INCLUDE memperbesar index, jadi tambahkan hanya kolom yang benar-benar dipakai query panas, bukan semua kolom tabel.
Tutorial: mengukur dan menambahkan index dengan EXPLAIN ANALYZE
Bagian ini adalah alur kerja yang bisa kamu ulangi untuk setiap query lambat. Jangan menebak index apa yang dibutuhkan; ukur dulu, tambahkan, lalu ukur lagi.
Langkah 1: buat tabel contoh dan isi data
CREATE TABLE orders (
    id          bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    customer_id bigint NOT NULL,
    status      text NOT NULL,
    total       numeric(12, 2) NOT NULL,
    created_at  timestamptz NOT NULL DEFAULT now()
);
Perhatikan bahwa id sebagai primary key sudah otomatis mendapat index B-tree. Jangan membuat index manual kedua pada id. Untuk eksperimen, isi tabel dengan data dalam jumlah yang cukup besar agar perbedaan sequential scan dan index scan terlihat; tabel dengan seratus baris tidak akan menunjukkan apa-apa karena planner memang akan memilih sequential scan untuk tabel kecil.
Langkah 2: ukur sebelum ada index
EXPLAIN ANALYZE
SELECT * FROM orders WHERE customer_id = 42;
Perhatikan dua hal di output. Pertama, jenis node: Seq Scan on orders berarti PostgreSQL membaca seluruh tabel. Kedua, waktu eksekusi aktual, bukan estimasi. EXPLAIN saja hanya menampilkan rencana; EXPLAIN ANALYZE benar-benar menjalankan query dan melaporkan waktu nyata. Itulah alasan EXPLAIN ANALYZE adalah alat utama di bagian ini.
Langkah 3: buat index tanpa memblokir tulis
CREATE INDEX CONCURRENTLY idx_orders_customer_id
ON orders (customer_id);
CONCURRENTLY membangun index tanpa mengunci tabel dari operasi tulis. Ini adalah pilihan yang tepat untuk tabel produksi. Ada dua konsekuensi yang harus diterima: prosesnya lebih lambat daripada build biasa, dan perintah ini tidak bisa dijalankan di dalam blok transaksi. Bila kamu menjalankan migrasi lewat framework yang membungkus semua pernyataan dalam satu transaksi, buat migrasi khusus untuk index ini, atau jalankan di luar transaksi. Praktik deployment seperti ini dibahas juga dalam panduan pipeline CI/CD.
Langkah 4: ukur lagi dan bandingkan
EXPLAIN ANALYZE
SELECT * FROM orders WHERE customer_id = 42;
Yang kamu harapkan adalah node berubah menjadi Index Scan atau Index Only Scan dengan waktu eksekusi yang turun. Bila node tetap Seq Scan, jangan langsung menambah index lain. Periksa kemungkinan penyebabnya: statistik tabel kedaluwarsa sehingga planner salah mengestimasi selektivitas (jalankan ANALYZE orders), query memakai fungsi atas kolom sehingga index biasa tidak cocok, atau tabel terlalu kecil sehingga sequential scan memang pilihan yang benar.
Langkah 5: uji query yang memakai kolom kedua
CREATE INDEX idx_orders_customer_created
ON orders (customer_id, created_at);

EXPLAIN ANALYZE
SELECT * FROM orders
WHERE customer_id = 42
ORDER BY created_at DESC
LIMIT 20;
Composite index ini melayani filter sekaligus pengurutan: baris untuk satu pelanggan sudah tersimpan berurutan berdasarkan created_at di dalam index, sehingga ORDER BY ... LIMIT 20 bisa berhenti setelah 20 baris pertama tanpa sort tambahan.
Contoh nyata: tiga pola query, tiga index berbeda
Satu tabel pesanan yang sama menghasilkan pola query yang sangat berbeda, dan masing-masing pola menuntut index yang berbeda. Tiga contoh berikut diambil dari pola yang berulang di aplikasi nyata.
Pola 1: daftar pesanan per pelanggan, terbaru dulu
Ini adalah pola composite index dari bagian tutorial: (customer_id, created_at DESC). Filter pada kolom pertama, urutan pada kolom kedua, dan LIMIT kecil membuat index ini sangat efektif. Bila halaman daftar ini adalah halaman yang paling sering dibuka, index ini adalah kandidat pertama yang harus ada.
Pola 2: pencarian di dalam metadata JSONB
Misalkan setiap pesanan menyimpan metadata fleksibel di kolom payload jsonb, dan tim support sering mencari pesanan berdasarkan kunci di dalamnya.
CREATE INDEX idx_orders_payload_gin
ON orders USING gin (payload);

SELECT * FROM orders
WHERE payload @> '{"channel": "mobile"}';
Operator @> (contains) adalah kasus klasik GIN. Tanpa index ini, setiap pencarian harus memindai dan mengurai dokumen JSONB setiap baris. Dengan GIN, PostgreSQL langsung menemukan baris yang dokumennya mengandung pasangan kunci-nilai itu. Perlu dicatat: bila beban kerjamu adalah pencarian kemiripan vektor, bukan containment JSONB, jenis index yang relevan berbeda dan dibahas dalam perbandingan vector database.
Pola 3: laporan atas tabel log yang sangat besar
Tabel log yang hanya ditambahi baris baru dan hampir tidak pernah diubah, dengan kolom created_at yang terurut secara alami seiring waktu, adalah kandidat BRIN.
CREATE INDEX idx_events_created_brin
ON events USING brin (created_at);
BRIN untuk tabel seperti ini bisa berukuran sangat kecil dibanding B-tree, karena ia hanya menyimpan ringkasan per rentang blok. Query laporan per rentang tanggal tetap bisa memangkas blok-blok di luar rentang. Tetapi bila baris log dimasukkan tidak berurutan, misalnya import massal data lama yang tercampur, BRIN kehilangan kemampuannya memangkas dan kamu harus kembali ke B-tree.
Kesalahan umum dan cara menghindarinya
Kesalahan pertama adalah mengindeks kolom yang salah. Kolom boolean atau kolom dengan dua nilai yang mungkin, misalnya is_active, hampir tidak pernah selektif sendirian: index-nya tidak mempersempit hasil secara berarti, sehingga planner akan mengabaikannya. Index seperti itu hanya menambah biaya tulis. Pengecualian adalah partial index, di mana kamu mengindeks subset kecil yang menarik, bukan seluruh kolom.
Kesalahan kedua adalah membuat index yang tumpang tindih. Index (customer_id) dan (customer_id, created_at) pada tabel yang sama adalah redundansi: index kedua sudah bisa melayani semua query yang dilayani index pertama. Audit berkala terhadap daftar index, dan hapus yang duplikatif, adalah perawatan yang murah dan berdampak langsung pada kecepatan tulis.
Kesalahan ketiga adalah memakai fungsi di WHERE tanpa expression index. Query WHERE lower(email) = ... atau WHERE created_at::date = ... tidak bisa memakai index biasa pada kolom mentahnya. Solusinya bukan menambah index biasa kedua, melainkan expression index yang ekspresinya persis sama dengan yang ada di query.
Kesalahan keempat adalah pola LIKE '%teks%' dengan awalan wildcard. B-tree tidak bisa memakai prefix yang tidak diketahui, sehingga pola ini tetap sequential scan meskipun kolomnya terindeks. Untuk pencarian substring seperti ini, solusinya adalah trigram index dari ekstensi pg_trgm dengan GIN atau GiST, atau full-text search, bukan B-tree biasa.
Kesalahan kelima adalah mengabaikan statistik. Planner memilih index berdasarkan estimasi jumlah baris yang cocok. Bila statistik kedaluwarsa setelah perubahan data besar, planner bisa memilih rencana yang salah meskipun index yang benar sudah ada. Jalankan ANALYZE setelah bulk load atau perubahan data besar, dan periksa apakah autovacuum berjalan normal di database produksi.
Merawat index yang sudah ada
Index yang sudah dibuat bukan pekerjaan yang selesai selamanya. Tiga pemeriksaan berikut cukup dilakukan berkala.
Pertama, ukur ukuran index. Kueri katalog pg_indexes memberi daftar index per tabel, dan fungsi pg_relation_size memberi ukurannya. Bila total ukuran index sudah melebihi ukuran tabel itu sendiri secara signifikan, itu sinyal bahwa ada index yang terlalu banyak atau terlalu lebar.
Kedua, identifikasi index yang tidak terpakai lewat pg_stat_user_indexes. Kolom idx_scan menunjukkan berapa kali index itu dipakai sejak statistik terakhir direset. Index dengan idx_scan nol selama periode pengamatan yang cukup panjang adalah kandidat penghapusan, dengan satu kehati-hatian: index yang menegakkan unique constraint atau primary key tidak boleh dihapus meskipun idx_scan-nya rendah, karena fungsinya adalah penegakan aturan, bukan kecepatan query.
Ketiga, bangun ulang index yang membengkak. Setelah banyak update dan delete, index bisa mengandung banyak ruang kosong dari entri yang sudah mati. REINDEX membangun ulang index dari nol. Untuk tabel produksi, varian CONCURRENTLY adalah pilihan yang aman karena tidak memblokir tulis, dengan catatan yang sama seperti CREATE INDEX CONCURRENTLY: tidak bisa di dalam blok transaksi.
Satu catatan tentang VACUUM: proses ini mereklamasi ruang dari baris yang sudah mati, termasuk entri index yang terkait. Autovacuum yang sehat adalah prasyarat agar index tetap efisien; mematikan autovacuum untuk "menghemat" justru membuat index dan tabel membengkak dari waktu ke waktu.
Best practice index PostgreSQL
Daftar berikut merangkum keputusan yang dibahas di seluruh artikel menjadi checklist yang bisa dipakai saat review skema.
- Mulai dari query yang lambat, bukan dari kolom yang "kelihatannya" perlu index. Buktikan dulu dengan EXPLAIN ANALYZE.
- Pilih B-tree sebagai default. Pindah ke GIN, GiST, atau BRIN hanya bila bentuk data atau pola query menuntutnya.
- Urutkan kolom composite index dari yang paling selektif dan paling sering difilter, ke yang paling jarang, dan hormati aturan leftmost prefix.
- Gunakan partial index untuk subset baris yang kecil dan sering dicari, dan expression index untuk filter atas hasil fungsi.
- Tambahkan kolom
INCLUDEhanya untuk kolom yang benar-benar dipakai query panas, bukan sebagai jalan pintas untuk menghindari akses tabel. - Buat index produksi dengan
CONCURRENTLYdan di luar blok transaksi. - Audit index secara berkala: hapus yang duplikatif dan yang tidak terpakai, dan periksa ukuran totalnya terhadap ukuran tabel.
- Jaga statistik tetap segar dengan ANALYZE setelah perubahan data besar, dan pastikan autovacuum berjalan.
- Dokumentasikan alasan setiap index non-trivial di migrasi atau di komentar skema, supaya enam bulan kemudian tidak ada yang menghapus index yang ternyata menopang query kritis.
Prinsip yang sama berlaku di lapisan aplikasi: panduan desain REST API menunjukkan bagaimana parameter filter dan pagination yang konsisten membuat pola query bisa diprediksi, dan pola query yang bisa diprediksi adalah prasyarat agar index yang kamu buat tetap relevan.
FAQ
Apakah primary key otomatis membuat index di PostgreSQL?
Ya. Primary key dan unique constraint secara otomatis membuat index B-tree di belakang layar, dan index itulah yang menegakkan keunikan. Jangan membuat index manual kedua pada kolom yang sama, karena itu hanya menggandakan biaya tulis dan ruang disk.
Berapa banyak index yang boleh dimiliki satu tabel?
Tidak ada angka ajaib. Tabel yang didominasi baca bisa menoleransi lebih banyak index daripada tabel yang didominasi tulis berat. Patokan praktisnya adalah mengukur: bila kecepatan tulis menurun atau total ukuran index sudah melampaui ukuran tabel, audit dan hapus index yang tidak memberi manfaat terukur.
Kenapa query saya tetap sequential scan padahal index sudah ada?
Penyebab paling umum adalah statistik kedaluwarsa, query memakai fungsi atas kolom tanpa expression index, atau tabel terlalu kecil sehingga sequential scan memang lebih murah. Jalankan EXPLAIN ANALYZE, periksa estimasi baris dibanding jumlah aktual, jalankan ANALYZE, dan periksa apakah predikat query benar-benar cocok dengan definisi index.
Apakah index memperlambat INSERT dan UPDATE?
Ya, setiap index menambah pekerjaan tulis karena setiap perubahan baris harus memperbarui setiap index pada tabel itu. Dampaknya sebanding dengan jumlah dan lebar index. Inilah alasan index yang tidak terpakai harus dihapus, dan alasan tabel tulis-berat harus punya index lebih sedikit daripada tabel baca-berat.
Kapan memakai GIN dan kapan memakai B-tree untuk kolom JSONB?
Pakai GIN bila query mencari di dalam dokumen, misalnya containment @>, keberadaan kunci ?, atau pencarian di dalam array. B-tree hanya berguna bila kamu memfilter seluruh nilai JSONB dengan equality, yang jarang terjadi. Untuk kebanyakan beban kerja JSONB, GIN adalah jawaban yang benar.
Kesimpulan
Index PostgreSQL adalah alat yang sederhana dalam konsep dan kaya dalam detail: B-tree untuk sebagian besar query, GIN untuk data komposit seperti JSONB dan array, GiST untuk data multidimensi, dan BRIN untuk tabel besar yang terurut alami. Composite, partial, expression, dan covering index memungkinkan kamu menyesuaikan index dengan pola query yang sebenarnya, bukan dengan tebakan.
Alur kerja yang benar selalu sama: ukur query yang lambat dengan EXPLAIN ANALYZE, pilih jenis dan kolom index dari pola query itu, buat dengan CONCURRENTLY di produksi, ukur lagi, lalu audit secara berkala. Index yang dibuat dari pengukuran dan dirawat dengan audit akan tetap memberi manfaat lama setelah query yang memotivasinya berubah.
Langkah berikutnya yang paling bernilai: pilih satu query lambat di aplikasimu hari ini, jalankan EXPLAIN ANALYZE sebelum dan sesudah menambahkan index yang tepat, dan catat perbedaannya. Satu pengukuran nyata lebih berguna daripada sepuluh index yang dibuat berdasarkan firasat.
Sumber referensi: dokumentasi PostgreSQL tentang index access method, dokumentasi PostgreSQL tentang multicolumn index, dan dokumentasi PostgreSQL tentang unique index.
Comments
Have a thought, a question, or something to add? Write it here.