Panduan OpenTelemetry: Observabilitas Modern dengan Traces, Metrics, dan Logs
Pelajari OpenTelemetry dari nol: konsep observabilitas, arsitektur SDK-Collector-OTLP, tiga sinyal traces-metrics-logs, sampling, dan tutorial instrumentasi Python dengan Docker Compose.
Panji Ihsanudin Fajri
14 min read0 reads
Contents
- Apa itu observabilitas?
- Monitoring vs observabilitas
- OpenTelemetry itu apa?
- Tiga sinyal utama: traces, metrics, logs
- Traces: mengikuti perjalanan satu request
- Metrics: angka yang diagregasi
- Logs: catatan kejadian
- Komponen arsitektur OpenTelemetry
- 1. API dan SDK
- 2. OTLP: protokol pengirim
- 3. Collector: pemroses perantara
- Tutorial: instrumentasi aplikasi Python dari nol
- Langkah 1 — Siapkan aplikasi
- Langkah 2 — Konfigurasi collector
- Langkah 3 — Jalankan semuanya
- Langkah 4 — Hasilkan traffic dan lihat hasilnya
- OpenTelemetry vs Prometheus vs Jaeger
- Sampling: mengendalikan biaya observabilitas
- Kesalahan umum
- Best practice
- FAQ
- Apakah OpenTelemetry menggantikan Prometheus?
- Bahasa pemrograman apa saja yang didukung OpenTelemetry?
- Apakah OpenTelemetry hanya untuk Kubernetes?
- Berapa overhead performa instrumentasi OpenTelemetry?
- Bagaimana cara bermigrasi dari agent vendor ke OpenTelemetry?
- Kesimpulan
Men-debug aplikasi monolit itu seperti memperbaiki sepeda: semua bagian terlihat, bunyinya terdengar dari mana. Aplikasi terdistribusi beda cerita. Satu request masuk lewat API gateway, melompat ke tiga microservice, mengantre di message broker, menyentuh dua database, lalu kembali. Ketika request itu lambat, tidak ada satu pun log yang bisa memberitahu kamu hop mana yang bermasalah. Di sinilah OpenTelemetry masuk.
OpenTelemetry adalah standar vendor-netral untuk mengumpulkan telemetri dari aplikasi: traces, metrics, dan logs. Artikel ini membahas observabilitas dari nol sampai praktik: apa bedanya dengan monitoring biasa, bagaimana arsitektur OpenTelemetry bekerja, dan cara menginstrumentasi aplikasi Python dengan collector yang benar-benar jalan.
Ringkasan:
- Observabilitas berarti kamu bisa menjawab pertanyaan baru tentang sistem tanpa deploy ulang — monitoring hanya menjawab pertanyaan yang sudah kamu antisipasi.
- OpenTelemetry adalah standar CNCF (graduated, Mei 2026) untuk menghasilkan dan mengirim traces, metrics, dan logs; ia bukan database, bukan dashboard.
- Tiga komponen intinya: SDK di kode aplikasi, Collector sebagai pemroses perantara, dan OTLP sebagai protokol pengirim.
- Satu kali instrumentasi, ganti backend cukup dengan mengubah konfigurasi exporter.
- Sampling di level collector adalah kunci agar biaya observabilitas tidak meledak.
Apa itu observabilitas?
Observabilitas adalah kemampuan untuk memahami kondisi internal sebuah sistem hanya dari data yang ia keluarkan. Istilah ini dipinjam dari teori kontrol: sebuah sistem disebut observable kalau kamu bisa merekonstruksi keadaan di dalamnya dari output yang bisa diamati.
Definisi praktisnya lebih sederhana. Sistem yang observable menjawab pertanyaan yang belum kamu pikirkan sebelumnya. "Kenapa request dari pengguna di Jakarta lambat padahal server sehat?" adalah pertanyaan observabilitas. "Berapa CPU server jam 3 sore?" bukan — itu pertanyaan monitoring, karena kamu sudah tahu sebelumnya bahwa CPU perlu diawasi.
Perbedaan ini penting karena sistem modern terlalu kompleks untuk diantisipasi sepenuhnya. Microservice, serverless, antrian, cache, database — jumlah kombinasi kegagalan tumbuh lebih cepat daripada dashboard yang bisa kamu buat. Observabilitas bukan soal mengumpulkan lebih banyak data, melainkan mengumpulkan data yang terhubung: satu request bisa dilacak dari ujung ke ujung, metriknya bisa dikorelasikan dengan log pada detik yang sama.
Monitoring vs observabilitas
Kedua istilah ini sering dipakai bergantian, padahal perannya berbeda.
| Aspek | Monitoring | Observabilitas |
|---|---|---|
| Pertanyaan | "Apakah X masih sehat?" | "Kenapa X berperilaku seperti ini?" |
| Data | Metrik dan alert yang sudah ditentukan | Trace, metrik, log yang terkorelasi |
| Waktu | Diketahui sebelum insiden | Ditemukan saat investigasi |
| Contoh | Alert CPU > 80% | Menelusuri satu request lambat antar service |
Monitoring memberi tahu kamu bahwa ada masalah. Observabilitas membantu menemukan di mana dan kenapa. Keduanya dibutuhkan; monitoring adalah garis pertahanan pertama, observabilitas adalah alat investigasinya.
OpenTelemetry itu apa?
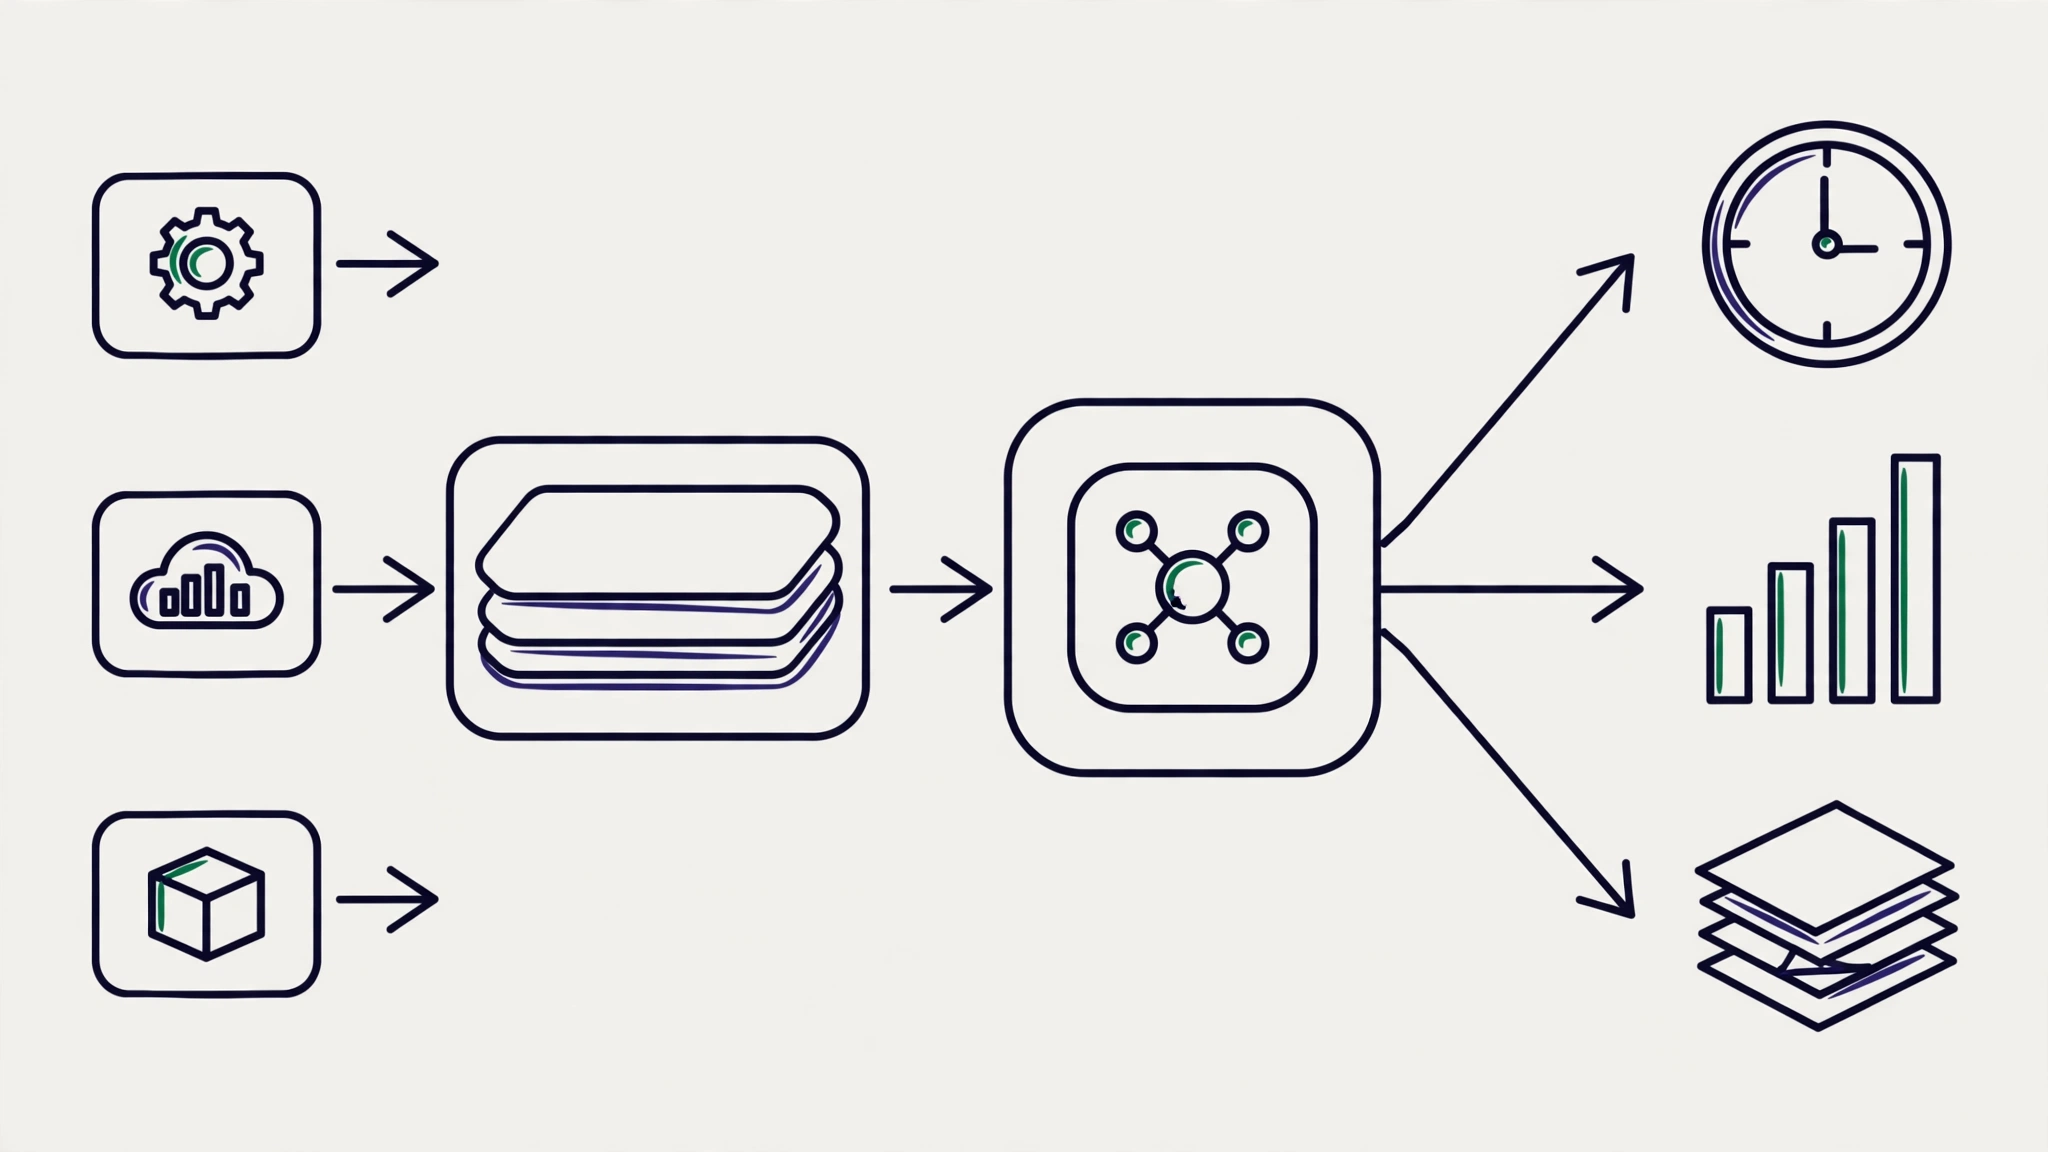
OpenTelemetry (disingkat OTel) adalah proyek open source di bawah Cloud Native Computing Foundation yang menyediakan standar untuk menghasilkan, memproses, dan mengirim telemetri. Proyek ini lahir tahun 2019 dari penggabungan OpenTracing dan OpenCensus, lalu naik status menjadi proyek graduated CNCF pada Mei 2026 — level kematangan tertinggi di CNCF.
Satu hal yang sering disalahpahami: OpenTelemetry bukan backend. Ia tidak menyimpan data, tidak menampilkan dashboard, dan tidak mengirim alert. Ia adalah "pipa" antara kode kamu dan backend observabilitas pilihanmu — Prometheus, Grafana, Jaeger, Datadog, atau apa pun yang bisa menerima data. Tugasnya selesai ketika telemetri sampai di backend dengan format yang konsisten.
Kenapa ini penting? Sebelum ada standar, setiap vendor punya agent dan format sendiri. Pindah dari satu vendor ke vendor lain berarti menulis ulang instrumentasi. Dengan OpenTelemetry, kamu menginstrumentasi sekali, lalu mengganti backend cukup dengan mengubah satu baris konfigurasi exporter. Kode aplikasi tidak disentuh.
Tiga sinyal utama: traces, metrics, logs
OpenTelemetry menangani tiga sinyal yang sudah stabil di SDK-sdK utamanya. (Sinyal keempat, profiling, masih berstatus alpha per Maret 2026 dan belum disarankan untuk workload produksi yang kritis.)
Traces: mengikuti perjalanan satu request
Trace merekam perjalanan satu request melintasi service. Trace terdiri dari span — unit kerja berdurasi, misalnya "query database" atau "panggil API pembayaran". Span-span tersusun sebagai pohon: span induk untuk request HTTP, span anak untuk tiap operasi di dalamnya. Setiap span mencatat waktu mulai-selesai, atribut (seperti http.route atau db.query), dan status sukses/gagal.
Ketika sebuah request melintasi batas service, context propagation menjaga keterhubungannya. Standar W3C Trace Context mendefinisikan header traceparent yang dibawa antar service lewat HTTP, gRPC, maupun message queue — tanpa header kustom, dan inilah yang membuat satu trace utuh bisa dirangkai dari puluhan service yang berbeda bahasa pemrograman.
Metrics: angka yang diagregasi
Metrics adalah pengukuran numerik yang diagregasi dari waktu ke waktu: jumlah request per detik, latensi p95, penggunaan memori. OpenTelemetry mendukung tiga jenis instrumen utama: counter (hanya naik, misalnya total request), gauge (bisa naik-turun, misalnya koneksi aktif), dan histogram (distribusi nilai, misalnya latensi). Metrics murah disimpan, cepat di-query, dan ideal untuk dashboard serta alert.
Logs: catatan kejadian
Logs adalah catatan kejadian dengan timestamp, yaitu baris teks (atau JSON terstruktur) yang ditulis aplikasi saat sesuatu terjadi. OpenTelemetry menstandarkan format log dan, yang lebih penting, menghubungkannya dengan trace: sebuah log error bisa membawa trace ID sehingga kamu bisa melompat dari baris log langsung ke trace lengkap request yang gagal.
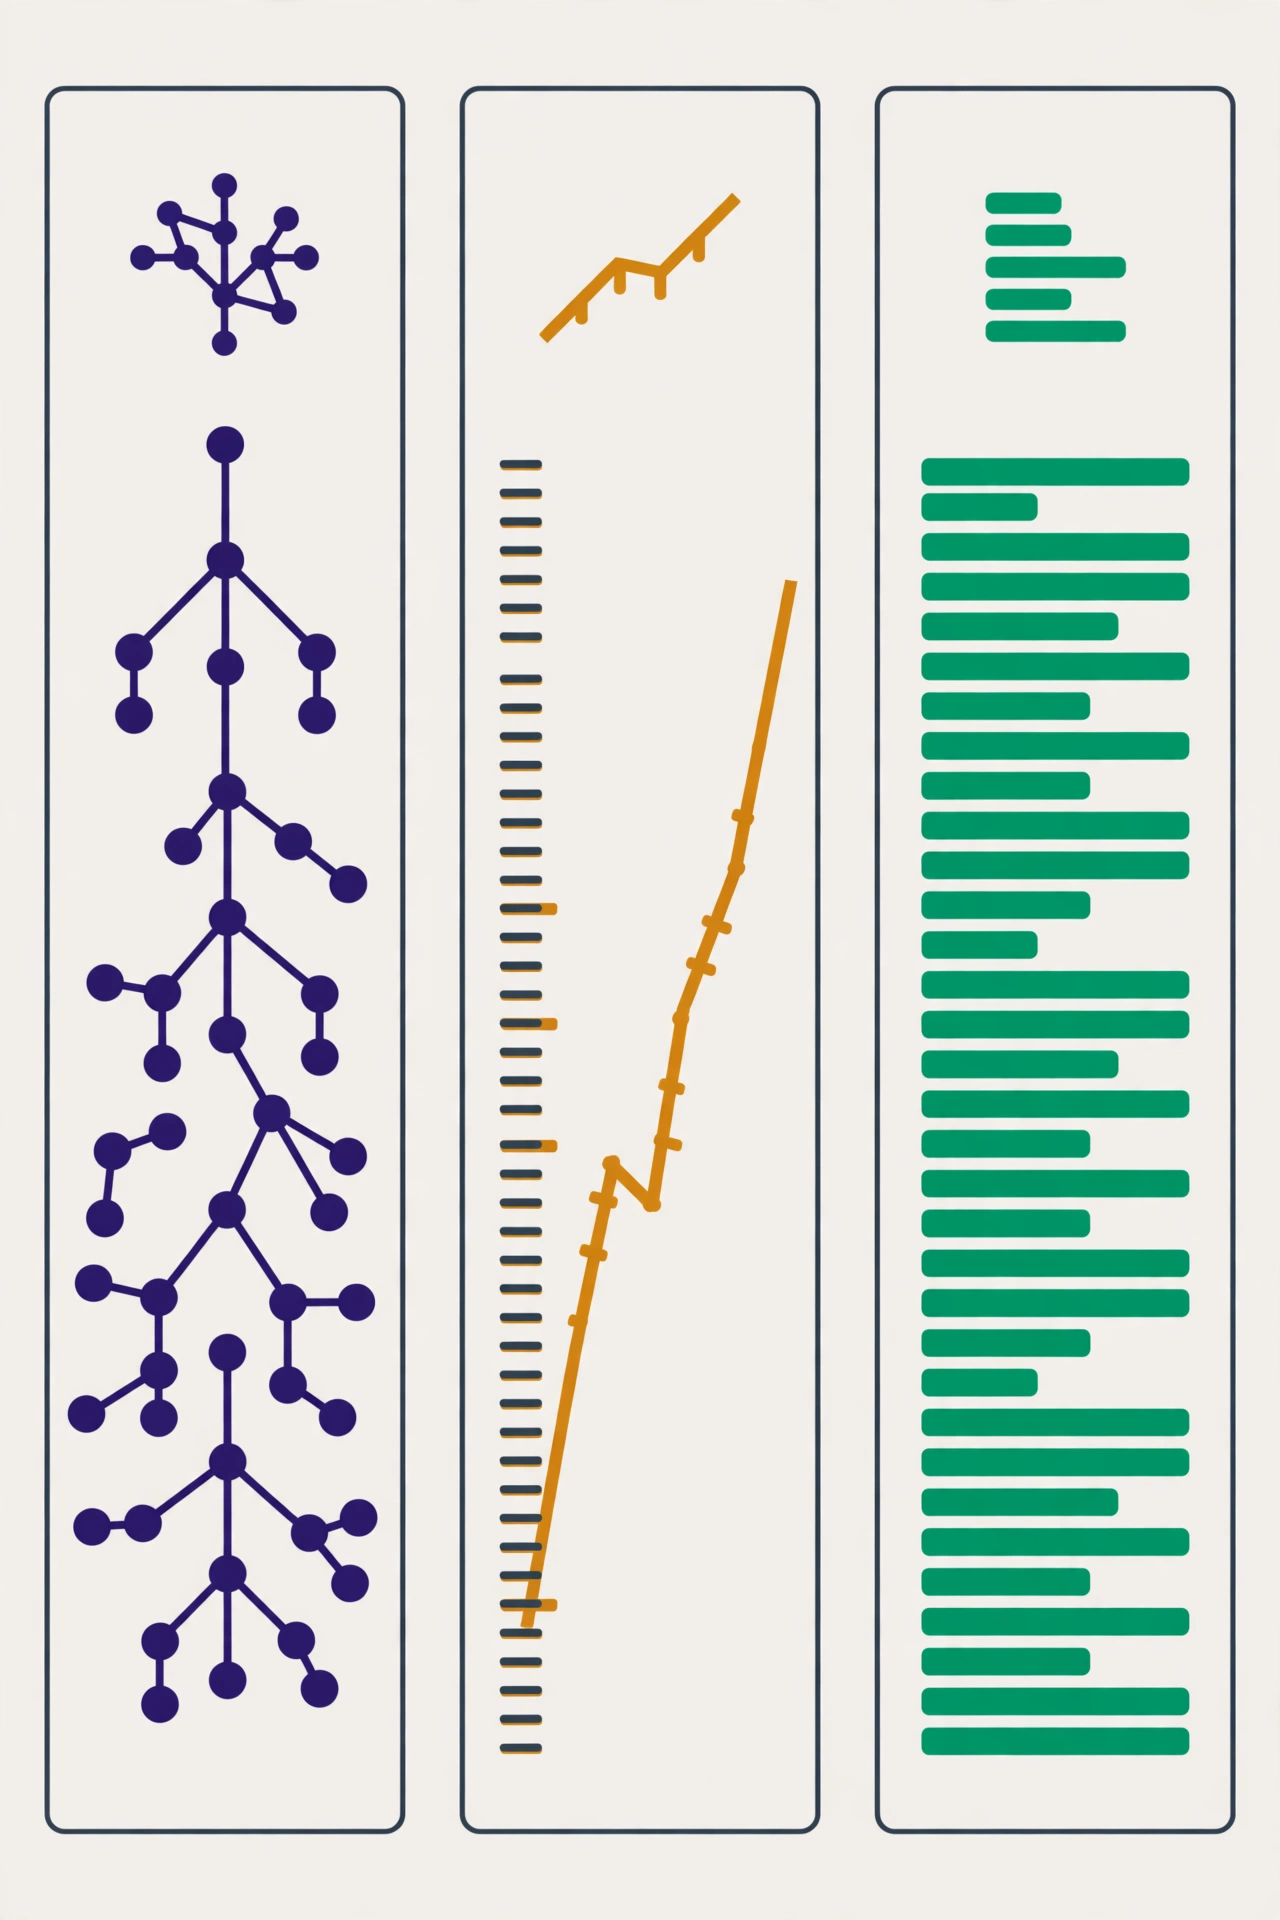
Ketiga sinyal ini saling melengkapi. Metrics memberi tahu ada anomali ("latensi p95 naik jam 14.00"), trace menunjukkan di mana ("span query database di service order lambat 800ms"), log menjelaskan kenapa ("timeout koneksi ke replica"). Tanpa ketiganya terkorelasi, investigasi insiden berubah jadi tebak-tebakan.
Komponen arsitektur OpenTelemetry
Arsitektur OTel punya tiga komponen utama, plus satu protokol yang mengikatnya.
1. API dan SDK
API adalah antarmuka yang dipakai kode aplikasi untuk membuat span, counter, dan log. SDK adalah implementasi yang benar-benar memprosesnya: meng-buffer span, mengagregasi metrik, lalu mengekspornya. Pemisahan ini disengaja — kode aplikasi hanya bergantung pada API yang ringan, sehingga mengganti SDK tidak mengubah kode.
Instrumentasi ada dua macam. Auto-instrumentation memasang hook ke library populer (FastAPI, Django, psycopg, redis-py) tanpa mengubah kode bisnis — cukup untuk memulai. Manual instrumentation menambahkan span dan atribut kustom di titik yang penting bagi bisnis kamu, misalnya durasi proses checkout per metode pembayaran. Praktik yang sehat menggabungkan keduanya: otomatis untuk fondasi, manual untuk detail yang spesifik.
2. OTLP: protokol pengirim
OTLP (OpenTelemetry Protocol) adalah protokol wire untuk mengirim telemetri. Ia berjalan di atas gRPC (port 4317) dan HTTP (port 4318), dengan endpoint terpisah per sinyal: /v1/traces, /v1/metrics, /v1/logs. Hampir semua backend observabilitas modern bisa menerima OTLP langsung; Prometheus bahkan punya mode receiver OTLP bawaan.
3. Collector: pemroses perantara
Collector adalah satu binary yang menerima telemetri, memprosesnya, lalu mengekspor ke backend. Konfigurasinya terdiri dari tiga blok:
- Receivers: dari mana data masuk (OTLP, Prometheus scrape, Kafka, dan banyak lagi).
- Processors: apa yang dilakukan ke data (batching, filter, sampling, pembatasan memori, pengubahan atribut).
- Exporters: ke mana data dikirim (OTLP, Prometheus, cloud provider, debug).
Ketiganya dirangkai menjadi pipeline per sinyal. Collector bisa dijalankan sebagai sidecar di tiap pod, daemonset per node, atau gateway terpusat. Keuntungan terbesarnya: kredensial backend, retry, dan sampling hidup di konfigurasi collector, bukan di kode aplikasi. Ganti backend observabilitas tanpa redeploy aplikasi.
Tutorial: instrumentasi aplikasi Python dari nol
Bagian ini praktik penuh. Kita akan menjalankan aplikasi FastAPI yang terinstrumentasi, collector, dan satu stack observabilitas lengkap (Grafana + Tempo + Mimir + Loki, dibundel dalam satu image grafana/otel-lgtm), semuanya dengan Docker Compose.
Langkah 1 — Siapkan aplikasi
Buat direktori proyek dengan struktur:
otel-demo/
├── app.py
├── requirements.txt
├── otelcol-config.yaml
└── docker-compose.yaml
requirements.txt:
fastapi
uvicorn
opentelemetry-api
opentelemetry-sdk
opentelemetry-exporter-otlp-proto-http
opentelemetry-instrumentation-fastapi
app.py — aplikasi checkout sederhana dengan instrumentasi manual di titik bisnis:
import time
import random
from fastapi import FastAPI
from opentelemetry import trace, metrics
from opentelemetry.sdk.trace import TracerProvider
from opentelemetry.sdk.trace.export import BatchSpanProcessor
from opentelemetry.exporter.otlp.proto.http.trace_exporter import OTLPSpanExporter
from opentelemetry.sdk.metrics import MeterProvider
from opentelemetry.sdk.metrics.export import PeriodicExportingMetricReader
from opentelemetry.exporter.otlp.proto.http.metric_exporter import OTLPMetricExporter
from opentelemetry.instrumentation.fastapi import FastAPIInstrumentor

# --- Traces ---
provider = TracerProvider()
provider.add_span_processor(
    BatchSpanProcessor(OTLPSpanExporter(endpoint="http://otel-collector:4318/v1/traces"))
)
trace.set_tracer_provider(provider)
tracer = trace.get_tracer(__name__)

# --- Metrics ---
reader = PeriodicExportingMetricReader(
    OTLPMetricExporter(endpoint="http://otel-collector:4318/v1/metrics")
)
metrics.set_meter_provider(MeterProvider(metric_readers=[reader]))
meter = metrics.get_meter(__name__)
checkout_counter = meter.create_counter(
    "checkout_requests_total", description="Total checkout requests"
)
checkout_latency = meter.create_histogram(
    "checkout_latency_ms", description="Checkout latency in milliseconds"
)

app = FastAPI()
FastAPIInstrumentor.instrument_app(app)  # auto-instrumentasi HTTP


@app.post("/checkout")
def checkout(items: int = 1):
    start = time.time()
    with tracer.start_as_current_span("checkout.process") as span:
        span.set_attribute("cart.items", items)
        # Simulasi panggilan ke service pembayaran
        with tracer.start_as_current_span("payment.charge"):
            time.sleep(random.uniform(0.05, 0.4))
        latency = (time.time() - start) * 1000
        checkout_counter.add(1, {"items": str(items)})
        checkout_latency.record(latency)
    return {"status": "ok", "latency_ms": round(latency, 1)}
Perhatikan pola di atas: auto-instrumentation menangani span HTTP secara otomatis, sedangkan span manual (checkout.process, payment.charge) menangkap logika bisnis yang spesifik. Keduanya tergabung dalam satu trace yang sama.
Langkah 2 — Konfigurasi collector
otelcol-config.yaml:
receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317
      http:
        endpoint: 0.0.0.0:4318

processors:
  memory_limiter:
    check_interval: 5s
    limit_mib: 512
  batch: {}

exporters:
  otlp/lgtm:
    endpoint: lgtm:4317
    tls:
      insecure: true

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [otlp/lgtm]
    metrics:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [otlp/lgtm]
    logs:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [otlp/lgtm]
Urutan processor penting: memory_limiter selalu pertama agar collector tidak kehabisan memori saat traffic melonjak, baru batch menggabungkan data sebelum dikirim.
Langkah 3 — Jalankan semuanya
docker-compose.yaml:
services:
  app:
    build: .
    ports:
      - "8000:8000"
    environment:
      - OTEL_EXPORTER_OTLP_ENDPOINT=http://otel-collector:4318
    depends_on:
      - otel-collector

  otel-collector:
    image: otel/opentelemetry-collector-contrib:0.161.0
    command: ["--config=/etc/otelcol/config.yaml"]
    volumes:
      - ./otelcol-config.yaml:/etc/otelcol/config.yaml:ro
    ports:
      - "4317:4317"
      - "4318:4318"
    depends_on:
      - lgtm

  lgtm:
    image: grafana/otel-lgtm:0.33.1
    ports:
      - "3000:3000"
Tambahkan Dockerfile sederhana (FROM python:3.12-slim, install requirements, CMD uvicorn app:app --host 0.0.0.0), lalu:
docker compose up --build
Langkah 4 — Hasilkan traffic dan lihat hasilnya
for i in $(seq 1 50); do
  curl -s -X POST "http://localhost:8000/checkout?items=$((RANDOM % 5 + 1))" > /dev/null
done
Buka http://localhost:3000 (login admin/admin), lalu:
- Explore → Tempo: cari trace, klik satu span
checkout.process: kamu akan melihat pohon span lengkap: span HTTP otomatis dari FastAPI, span manualcheckout.process, dan span anakpayment.chargedengan atributcart.items. - Explore → Prometheus/Mimir: query
rate(checkout_requests_total[1m])danhistogram_quantile(0.95, rate(checkout_latency_ms_bucket[5m]))untuk melihat throughput dan latensi p95. - Explore → Loki: log aplikasi yang terkorelasi dengan trace ID.
Satu perintah compose memberi kamu ketiga sinyal yang saling terhubung; fondasi yang sama dipakai di produksi, hanya backend-nya yang diganti.
OpenTelemetry vs Prometheus vs Jaeger
Pertanyaan yang sering muncul: "Kalau sudah pakai Prometheus dan Jaeger, buat apa OpenTelemetry?" Jawabannya: mereka mengisi peran berbeda.
| Aspek | OpenTelemetry | Prometheus | Jaeger |
|---|---|---|---|
| Peran | Menghasilkan & mengirim telemetri | Menyimpan metrik + alerting | Menyimpan & menampilkan trace |
| Sinyal | Trace, metrik, log | Metrik | Trace |
| Cara kerja | Push via OTLP | Pull via scrape (bisa terima OTLP) | Terima span, tampilkan UI trace |
| Ganti backend | Ubah config exporter | Perlu migrasi query/alert | Perlu migrasi instrumentasi |
Mereka justru dirancang untuk bekerja sama. Pola yang umum: instrumentasi dengan OTel SDK, kirim ke Collector, lalu Collector mengekspor metrik ke Prometheus dan trace ke Jaeger atau Tempo. Prometheus sendiri bisa menerima metrik OTLP langsung dengan flag --web.enable-otlp-receiver. Jadi ini bukan pilihan "salah satu", melainkan pembagian tugas.
Sampling: mengendalikan biaya observabilitas
Trace lengkap untuk setiap request terdengar ideal sampai kamu melihat tagihan storage. Aplikasi dengan 10.000 request per detik menghasilkan data trace dalam orde terabyte per hari. Di sinilah sampling berperan: memutuskan trace mana yang disimpan.
Ada dua pendekatan utama:
- Head-based sampling: keputusan diambil di awal, saat trace dibuat (misalnya simpan 10% secara acak). Murah dan sederhana, tapi kamu bisa kehilangan trace dari request yang ternyata bermasalah.
- Tail-based sampling: keputusan diambil di collector setelah trace lengkap terkumpul: simpan semua trace yang error atau lambat, buang yang normal. Lebih akurat, tapi butuh memori dan komputasi di collector.
Konfigurasi tail-based sampling di collector:
processors:
  tail_sampling:
    decision_wait: 10s
    num_traces: 100000
    policies:
      - name: errors
        type: status_code
        status_code: {status_codes: [ERROR]}
      - name: slow
        type: latency
        latency: {threshold_ms: 1000}
      - name: random-keep
        type: probabilistic
        probabilistic: {sampling_percentage: 5}
Aturan praktis: simpan 100% trace yang error, simpan trace lambat di atas threshold yang masuk akal untuk SLO kamu, dan simpan sampel acak kecil dari traffic normal sebagai baseline. Kombinasi ini biasanya memangkas volume data 90%+ tanpa kehilangan kemampuan investigasi.
Kesalahan umum
Menginstrumentasi semuanya, lalu kaget dengan tagihan. Mulai dari service yang paling sering bermasalah, bukan dari semua service sekaligus. Tambah cakupan setelah pipeline sampling berjalan.
Atribut dengan kardinalitas tinggi. Menaruh user_id atau order_id sebagai atribut metrik membuat jumlah time series meledak — setiap nilai unik adalah series baru. Atribut seperti itu cocok untuk span (trace), bukan untuk metrik. Untuk metrik, pakai atribut ber-kardinalitas rendah: route, status_code, region.
Span yang terlalu halus atau terlalu kasar. Satu span per baris kode membuat trace tidak terbaca; satu span per request membuat trace tidak berguna. Aturan praktis: buat span di batas yang bermakna: panggilan antar service, query database, operasi I/O eksternal, dan langkah bisnis penting.
Lupa mengkorelasikan log dengan trace. Log tanpa trace ID di sistem terdistribusi hanyalah tumpukan teks. Pastikan format log menyertakan trace ID dan span ID — sebagian besar SDK OTel bisa menyuntikkannya otomatis ke logging framework.
Tidak memantau collector itu sendiri. Collector adalah komponen infrastruktur. Aktifkan telemetry internal-nya (endpoint :8888 untuk metrik Prometheus bawaan) dan alert untuk antrian yang menumpuk atau data yang di-drop.
Best practice
- Standarkan penamaan sejak hari pertama. Ikuti semantic conventions OpenTelemetry untuk nama atribut (
http.route,db.system,messaging.destination) agar dashboard dan query konsisten antar service dan antar bahasa. - Pisahkan konfigurasi dari kode. Endpoint OTLP, level sampling, dan kredensial lewat environment variable atau config collector, bukan hardcode di aplikasi.
- Satu collector per pola deployment, bukan per aplikasi. Di Kubernetes, daemonset per node untuk aplikasi dan satu gateway terpusat untuk tail-based sampling adalah pola yang terbukti.
- Ukur dulu, sampling kemudian. Jalankan tanpa sampling agresif selama seminggu untuk memahami volume baseline, baru tentukan kebijakan sampling berdasarkan data nyata.
- Perlakukan telemetri seperti API publik. Mengubah nama span atau menghapus atribut bisa merusak dashboard dan alert tim lain. Versikan perubahannya seperti kamu memversikan API.
- Mulai dari RED/USE. Untuk tiap service, pastikan kamu punya Rate, Error, Duration (RED) untuk request-driven service, atau Utilization, Saturation, Error (USE) untuk resource. Ini memberi nilai observabilitas dalam hitungan jam, bukan minggu.
FAQ
Apakah OpenTelemetry menggantikan Prometheus?
Tidak. OpenTelemetry menghasilkan dan mengirim data; Prometheus menyimpan metrik dan menjalankan alert. Keduanya melengkapi: instrumentasi sekali dengan OTel, simpan metrik di Prometheus. Prometheus bahkan bisa menerima data OTLP langsung.
Bahasa pemrograman apa saja yang didukung OpenTelemetry?
SDK tersedia untuk bahasa-bahasa utama: Python, Java, Go, JavaScript/TypeScript (Node.js dan browser), .NET, Ruby, PHP, Rust, C++, dan Swift. Traces, metrics, dan logs berstatus stabil di SDK utama; dukungannya merata karena semuanya mengikuti spesifikasi yang sama.
Apakah OpenTelemetry hanya untuk Kubernetes?
Tidak. OpenTelemetry tidak bergantung pada platform. Ia berjalan di VM, serverless, bahkan IoT, selama aplikasi bisa mengirim OTLP ke collector atau backend. Pola deployment-nya (sidecar, daemonset, gateway) memang populer di Kubernetes, tapi konsepnya sama di mana pun.
Berapa overhead performa instrumentasi OpenTelemetry?
Auto-instrumentation yang wajar menambah overhead satu digit persen pada latensi, biasanya 1–5% tergantung seberapa banyak span yang dibuat. SDK dirancang non-blocking: span di-buffer dan diekspor secara batch di background thread. Kalau overhead jadi masalah, kurangi granularitas span atau naikkan interval batch sebelum menyalahkan framework-nya.
Bagaimana cara bermigrasi dari agent vendor ke OpenTelemetry?
Jalankan keduanya paralel sementara waktu: instrumentasi OTel mengirim ke backend baru, agent lama tetap jalan. Bandingkan data selama satu-dua sprint, pindahkan dashboard dan alert bertahap, lalu matikan agent lama. Karena OTel vendor-netral, langkah "pindah backend" berikutnya tidak akan sesulit migrasi pertama ini.
Kesimpulan
Observabilitas bukan soal tools, melainkan soal kemampuan menjawab pertanyaan yang belum terpikirkan. OpenTelemetry memberi fondasi standarnya: satu cara menginstrumentasi, satu protokol pengiriman, dan kebebasan memilih backend. Mulai dari satu service, hubungkan trace-metrik-log, kendalikan volume dengan sampling, lalu perluas.
Langkah berikutnya yang konkret: jalankan demo di artikel ini, lalu ganti exporter otlp/lgtm dengan backend yang sudah tim kamu pakai. Kalau belum punya backend, stack LGTM dari tutorial ini cukup untuk memulai. Untuk fondasi backend yang lebih luas, baca juga panduan pipeline CI/CD agar telemetri ter-deploy otomatis, panduan Docker untuk developer untuk pola container yang dipakai di sini, dan strategi caching dengan Redis — karena cache adalah tersangka pertama setiap kali latensi naik.
Referensi: dokumentasi OpenTelemetry, halaman proyek OpenTelemetry di CNCF, W3C Trace Context, dokumentasi Prometheus, dokumentasi Jaeger.
Comments
Have a thought, a question, or something to add? Write it here.