Panduan Memori AI Agent: Short-Term, Long-Term, dan Cara Mendesainnya
Panduan praktis memori AI agent: jenis memori, pola arsitektur, perbandingan Mem0 vs Letta vs Zep, dan contoh implementasi Python.
Panji Ihsanudin Fajri
16 min read0 reads
Contents
- Apa itu memori AI agent?
- Kenapa context window saja tidak cukup
- Tiga lapisan memori agent
- 1. Memori jangka pendek (working memory)
- 2. Memori episodik
- 3. Memori semantik dan prosedural
- Pola arsitektur memori yang umum dipakai
- 1. Riwayat penuh di prompt
- 2. Ringkasan percakapan (summarization)
- 3. Retrieval semantik atas fakta terekstraksi
- 4. Knowledge graph temporal
- 5. Manajemen memori ala sistem operasi
- 6. Memori berbasis file
- Cara kerja retrieval: dari percakapan ke fakta tersimpan
- Studi kasus kode: membangun memori sederhana dengan Python
- Mem0 vs Letta vs Zep: memilih pendekatan
- Kesalahan umum dan cara menghindarinya
- Best practice mendesain memori agent
- FAQ
- Apakah memori agent sama dengan context window?
- Berapa lama memori agent bertahan?
- Apakah cukup menyimpan seluruh riwayat percakapan?
- Bagaimana cara menghapus memori yang salah atau kedaluwarsa?
- Apakah memori agent aman untuk data sensitif?
- Kesimpulan
Bayangkan kamu punya asisten pribadi yang hebat: dia mengerti instruksi rumit, bisa menelepon API, dan menulis kode. Tapi setiap pagi dia bangun dengan ingatan kosong. Dia lupa namamu, lupa proyek yang kalian kerjakan kemarin, dan lupa bahwa kamu tidak suka rapat hari Senin. Itulah kondisi kebanyakan AI agent hari ini — cerdas, tapi amnesia. Artikel ini membahas memori AI agent: apa itu, kenapa context window saja tidak cukup, pola arsitektur yang dipakai di produksi, dan cara membangunnya sendiri dengan contoh kode Python.
Ringkasan: Memori AI agent adalah sistem yang menyimpan dan mengambil informasi antar sesi agar agent tetap konsisten. Context window itu memori jangka pendek yang mahal dan terbatas; memori jangka panjang menyimpan fakta terekstraksi, riwayat episodik, atau graf pengetahuan. Pola populernya: ringkasan percakapan, retrieval semantik (Mem0), knowledge graph temporal (Zep/Graphiti), dan manajemen memori ala sistem operasi (Letta). Artikel ini juga memuat contoh implementasi Python dari nol, perbandingan pendekatan, kesalahan umum, dan best practice.
Apa itu memori AI agent?
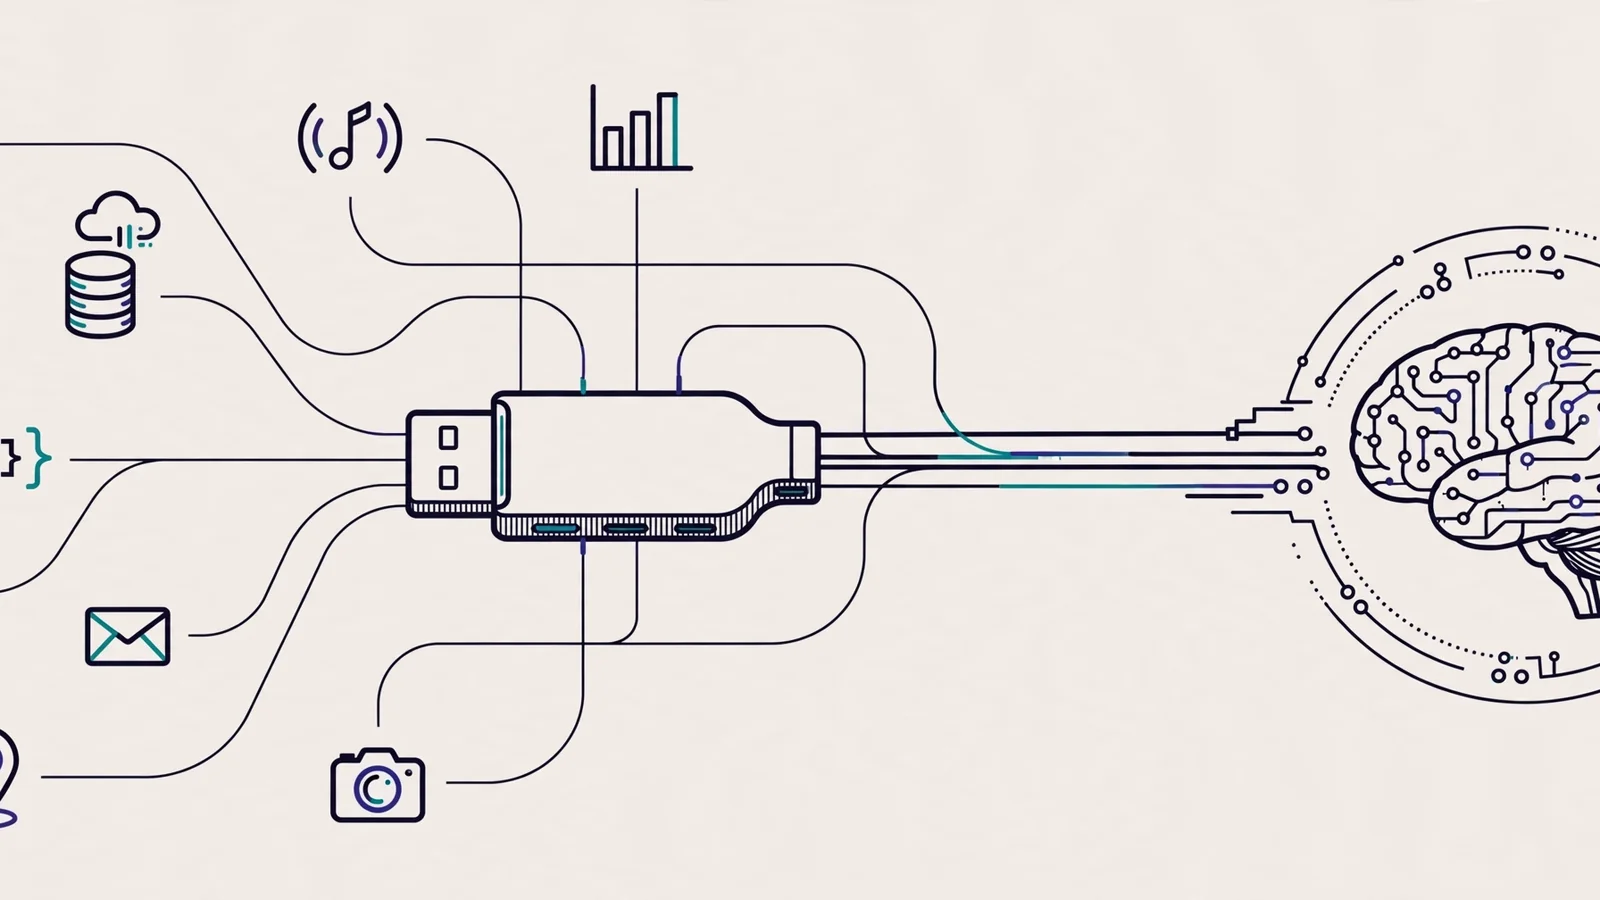
Memori AI agent adalah komponen yang memungkinkan agent menyimpan informasi dari interaksi sebelumnya dan mengambilnya kembali saat dibutuhkan — antar turn dalam satu sesi, maupun antar sesi yang berbeda. Tanpa memori, agent bersifat stateless: setiap percakapan baru dimulai dari nol, dan satu-satunya "ingatan" yang dia punya adalah teks yang kamu kirim di prompt saat itu juga.
Penting untuk membedakan dua hal yang sering dicampuradukkan. Yang pertama adalah context window, yaitu memori kerja bawaan model bahasa: semua token yang sedang diproses dalam satu pemanggilan. Yang kedua adalah sistem memori yang kamu rancang di sekitar model: tempat fakta disimpan, cara fakta dipilih, dan kapan fakta dimuat kembali ke context window. Context window adalah RAM yang kecil dan mahal; sistem memori adalah seluruh arsitektur penyimpanan di sekitarnya.
Anthropic, dalam panduan membangun agent yang banyak dirujuk developer, menempatkan memory sejajar dengan retrieval dan tool use sebagai augmentasi dasar dari LLM — model yang baik bisa "menentukan informasi apa yang perlu dipertahankan" sendiri (Building effective agents). Artinya memori bukan fitur tempelan, melainkan bagian dari desain agent sejak awal.
Kenapa context window saja tidak cukup
Cara paling naif memberi ingatan pada agent adalah menempel seluruh riwayat percakapan ke setiap prompt. Untuk sesi singkat, cara ini bekerja. Untuk pemakaian nyata, ia runtuh karena empat alasan.
Pertama, biaya dan latensi. Setiap token yang kamu kirim ulang dibayar ulang. Riwayat 50.000 token yang ditempel di setiap turn berarti kamu membayar 50.000 token berkali-kali untuk informasi yang sebagian besar tidak relevan dengan pertanyaan saat ini.
Kedua, sinyal tenggelam dalam noise. Model bahasa punya kecenderungan "lost in the middle": informasi penting yang terkubur di tengah konteks panjang lebih sulit diambil dengan akurat dibanding informasi di awal atau akhir. Menumpuk riwayat mentah justru menurunkan kualitas jawaban.
Ketiga, sesi berakhir, ingatan hilang. Context window hidup hanya selama sesi. Begitu percakapan ditutup, semuanya lenyap. Agent yang seharusnya mengenal preferensimu minggu lalu kembali menjadi orang asing.
Keempat, tidak ada struktur. Riwayat mentah adalah teks berurutan. Agent tidak bisa bertanya "apa keputusan arsitektur yang kita buat bulan lalu?" tanpa membaca semuanya. Memori yang baik menyimpan fakta yang sudah terekstraksi, bukan transkrip mentah.
Solusinya bukan context window yang lebih besar — itu hanya menunda masalah. Solusinya adalah sistem memori yang memutuskan apa yang disimpan, bagaimana disimpan, dan apa yang diambil kembali.
Tiga lapisan memori agent
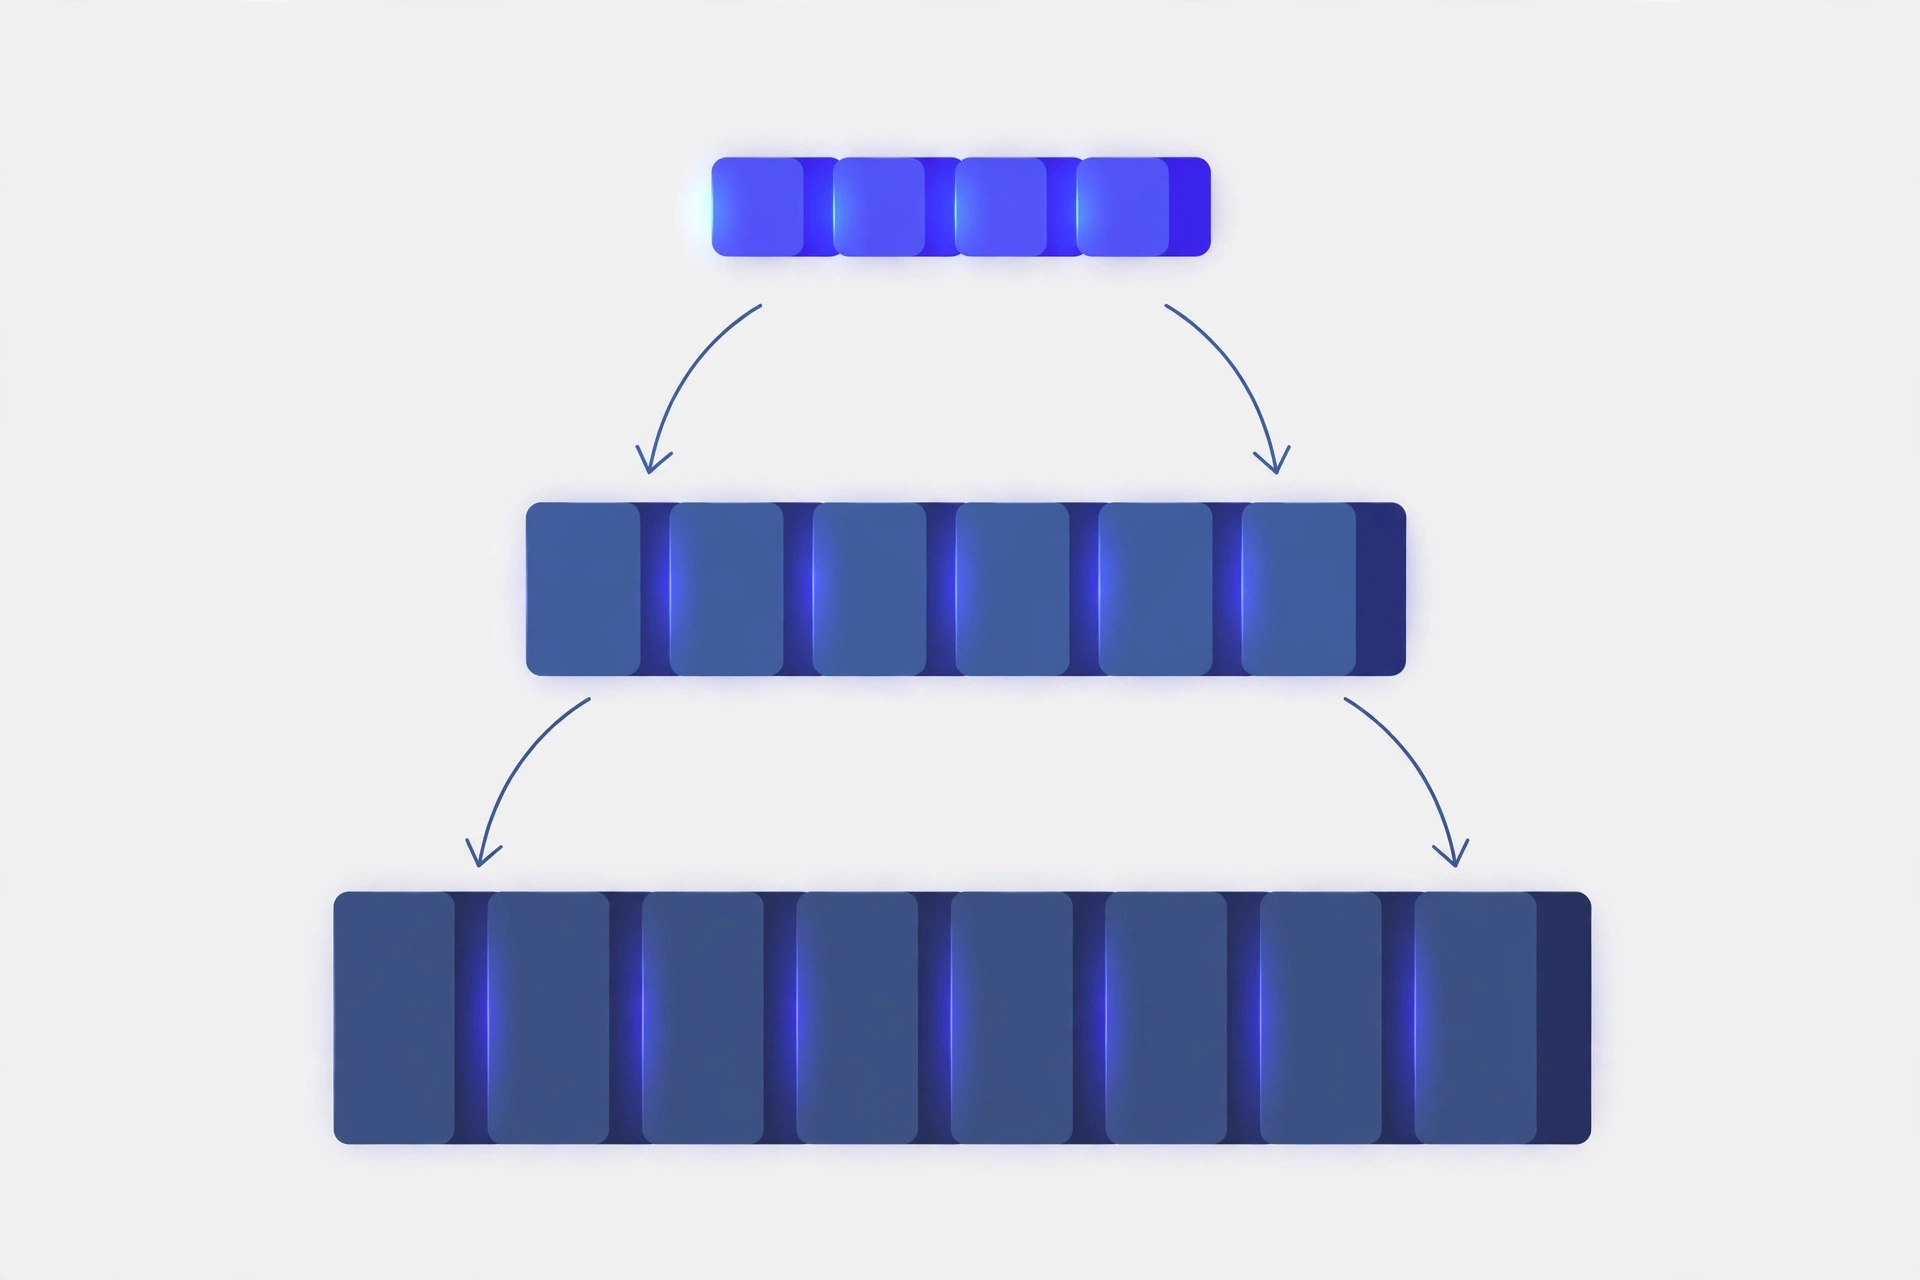
Meminjam istilah dari ilmu kognitif, memori agent biasanya dibagi tiga lapisan. Pembagian ini membantu karena tiap lapisan punya karakteristik dan teknologi penyimpanan yang berbeda.
1. Memori jangka pendek (working memory)
Ini adalah context window itu sendiri: pesan-pesan terakhir, hasil tool call barusan, dan status tugas yang sedang berjalan. Cepat, selalu tersedia, tapi terbatas dan hilang saat sesi berakhir. Yang perlu kamu desain di sini bukan penyimpanannya, melainkan manajemennya: kapan memangkas riwayat, kapan meringkas, dan seberapa banyak riwayat yang dipertahankan.
2. Memori episodik
Catatan tentang kejadian: "tanggal 14 Oktober, pengguna meminta migrasi database dan kita memilih strategi X karena Y". Memori episodik menjawab pertanyaan "kapan" dan "dalam konteks apa". Implementasinya biasanya berupa log percakapan yang bisa dicari — bukan seluruh transkrip yang ditempel, melainkan episode-episode yang diambil berdasarkan relevansi.
3. Memori semantik dan prosedural
Fakta yang sudah dilepas dari konteks kejadiannya: "pengguna lebih suka kursi lorong", "proyek ini memakai PostgreSQL", "deploy selalu lewat branch main". Memori prosedural adalah selangkah lebih jauh: cara melakukan sesuatu yang agent pelajari dari pengalaman, misalnya "kalau API ini mengembalikan 429, tunggu 60 detik sebelum retry". Lapisan inilah yang membuat agent terasa "mengenal" penggunanya dari waktu ke waktu.
Tiga lapisan ini tidak harus diimplementasikan sebagai tiga database terpisah. Banyak sistem menggabungkannya dalam satu penyimpanan dengan metadata berbeda. Yang penting adalah kamu sadar ketiganya ada dan memperlakukannya berbeda saat menulis dan membaca.
Pola arsitektur memori yang umum dipakai
Ada enam pola yang dominan di ekosistem saat ini, dari yang paling sederhana sampai yang paling eksplisit.
1. Riwayat penuh di prompt
Pola naif: tempel N pesan terakhir ke setiap pemanggilan. Cocok untuk chatbot sesi pendek. Kelemahannya sudah dibahas di atas — mahal, berisik, dan tidak lintas sesi. Kalau agent-mu hanya hidup dalam satu percakapan singkat, pola ini cukup. Kalau lebih dari itu, lanjutkan membaca.
2. Ringkasan percakapan (summarization)
Begitu riwayat melewati ambang tertentu, panggil LLM untuk meringkasnya menjadi paragraf padat, lalu ganti riwayat lama dengan ringkasan itu. Pola ini murah dan mudah: satu tabel database, satu prompt ringkasan. Kelemahannya, detail spesifik hilang dalam ringkasan — "pengguna memakai PostgreSQL 16.4" bisa menyusut menjadi "pengguna memakai database". Untuk fakta yang harus presisi, ringkasan saja tidak cukup.
3. Retrieval semantik atas fakta terekstraksi
Ini pola yang dipopulerkan Mem0: setiap ada pesan baru, sebuah LLM mengekstrak fakta-fakta penting ("pengguna vegetarian", "keputusan: pakai Postgres"), menyimpannya sebagai entri terstruktur di vector database, dan saat ada pertanyaan baru, hanya fakta yang relevan secara semantik yang diambil kembali. Alih-alih mengirim 10.000 token riwayat, kamu mengirim beberapa ratus token fakta terfilter. Memori di-scope per user_id, agent_id, dan run_id sehingga ingatan satu pengguna tidak bocor ke pengguna lain. Mem0 bersifat open source (Apache 2.0) dan bisa di-self-host.
4. Knowledge graph temporal
Pola ini, dipakai oleh Zep lewat mesin open-source-nya Graphiti, menyimpan memori sebagai graf: entitas (orang, proyek, keputusan) dihubungkan oleh relasi bertipe, masing-masing dengan jendela waktu keberlakuan. Keunggulannya adalah pertanyaan relasional: "siapa yang memutuskan X dan kapan keputusan itu berubah?" bisa dijawab dengan traversing graf, bukan sekadar kemiripan vektor. Retrieval-nya hibrida — pencarian semantik, pencocokan kata kunci, dan traversal graf digabung. Perbandingan mendalam antar pendekatan memori bisa dibaca di analisis lanskap vendor memori agent 2026.
5. Manajemen memori ala sistem operasi
Pendekatan paling eksplisit datang dari Letta (dulu bernama MemGPT, lahir sebagai riset di UC Berkeley). Letta memperlakukan context window seperti RAM dan penyimpanan eksternal seperti disk: ada core memory (blok kecil yang selalu ada di konteks, seperti identitas dan persona), recall memory (riwayat percakapan yang bisa dicari), dan archival memory (fakta jangka panjang di vector store). Yang istimewa: agent sendiri yang mengelola paging lewat tool call — archival_memory_insert untuk menyimpan, archival_memory_search untuk mengambil, memory_replace untuk menulis ulang blok inti. Tidak ada proses ekstraktor di belakang layar; model yang memutuskan apa yang layak diingat.
6. Memori berbasis file
Pola paling sederhana yang sedang naik daun: tulis ingatan sebagai file teks biasa yang selalu dibaca di awal sesi — seperti MEMORY.md atau AGENTS.md yang dibaca coding agent populer. Tidak ada vector database, tidak ada ekstraksi LLM. Kelebihannya: transparan, mudah di-debug, dan bisa diedit manusia langsung. Kelemahannya: tidak berskala untuk ribuan fakta dan tidak ada retrieval selektif. Untuk agent pribadi dengan puluhan fakta penting, pola ini sering kali sudah lebih dari cukup.
Tidak ada pola yang selalu menang. Pilih berdasarkan skala: file untuk puluhan fakta, retrieval semantik untuk ratusan–ribuan fakta lintas sesi, graf untuk pertanyaan relasional dan temporal, dan pendekatan OS untuk agent otonom jangka panjang yang perlu mengelola memorinya sendiri.
Cara kerja retrieval: dari percakapan ke fakta tersimpan
Terlepas dari pola yang kamu pilih, alur kerjanya selalu punya tiga tahap yang sama: tulis, simpan, dan baca kembali.
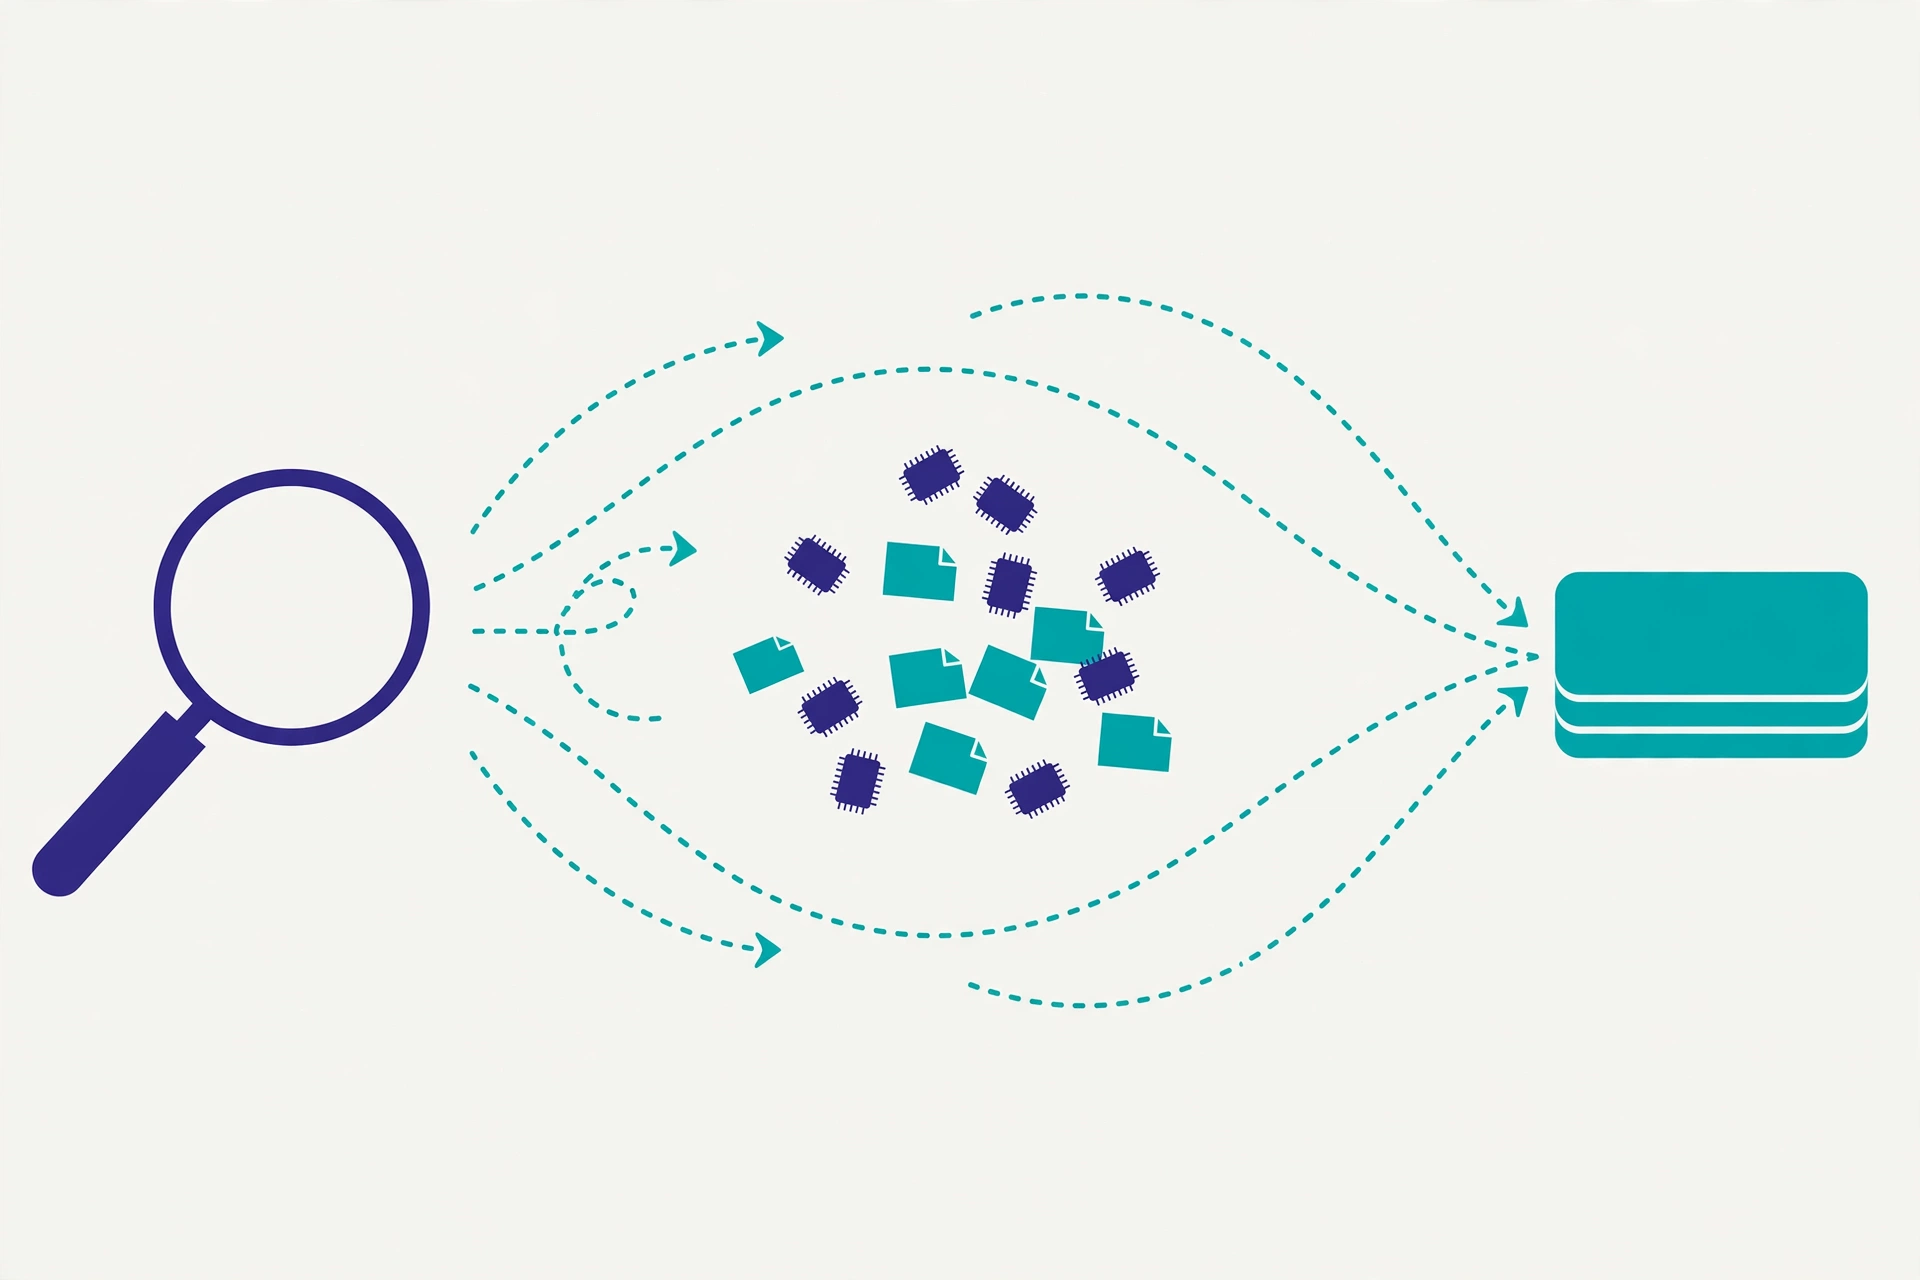
Tahap tulis terjadi setelah ada informasi baru. Sistem memutuskan apakah informasi itu layak disimpan — tidak semua pesan layak jadi memori. "Halo" tidak perlu disimpan; "deploy hari Jumat jam 5 sore" perlu. Pada pola Mem0, keputusan ini dibuat oleh LLM ekstraktor; pada pola file, kamulah yang menulis manual; pada pola Letta, agent sendiri yang memanggil tool penyimpanan.
Tahap simpan mengubah informasi menjadi representasi yang bisa dicari: embedding vektor, node di graf, baris di database, atau sekadar paragraf di file. Metadata ikut disimpan: kapan fakta dibuat, milik siapa, dan dari episode mana ia berasal. Metadata inilah yang memungkinkan operasi seperti "lupakan semua yang lebih tua dari 90 hari" atau "tampilkan ingatan milik pengguna ini saja".
Tahap baca terjadi sebelum setiap pemanggilan model: query (biasanya pesan terakhir pengguna, kadang digabung konteks tugas) dipakai untuk mengambil kandidat memori, kandidat di-ranking berdasarkan relevansi, lalu top-K dimasukkan ke prompt. Detail yang sering diremehkan: batas jumlah. Mengambil 3 fakta relevan hampir selalu lebih baik daripada 30 fakta yang "mungkin relevan". Setiap fakta tambahan adalah token yang dibayar dan noise potensial.
Studi kasus kode: membangun memori sederhana dengan Python
Teori tanpa kode cepat menguap. Berikut implementasi memori minimal memakai pustaka bawaan Python saja (SQLite, tanpa LLM, tanpa vector database). Ia menyimpan fakta per pengguna dan mengambilnya berdasarkan kecocokan kata kunci plus kebaruan — cukup untuk memahami anatomi sistem memori sebelum kamu mengadopsi framework yang lebih berat.
import sqlite3
import time


class SimpleMemory:
    """Memori agent minimal: simpan fakta, ambil yang relevan."""

    def __init__(self, db_path="memory.db"):
        self.db = sqlite3.connect(db_path)
        self.db.execute(
            """CREATE TABLE IF NOT EXISTS facts (
                   id INTEGER PRIMARY KEY,
                   content TEXT NOT NULL,
                   user_id TEXT NOT NULL,
                   created_at REAL NOT NULL
               )"""
        )
        self.db.commit()

    def remember(self, content, user_id="default"):
        """Simpan satu fakta."""
        self.db.execute(
            "INSERT INTO facts (content, user_id, created_at)"
            " VALUES (?, ?, ?)",
            (content, user_id, time.time()),
        )
        self.db.commit()

    def recall(self, query, user_id="default", limit=5):
        """Ambil fakta relevan: cocokkan kata kunci, utamakan yang baru."""
        keywords = {w.lower() for w in query.split() if len(w) > 3}
        rows = self.db.execute(
            "SELECT content, created_at FROM facts WHERE user_id = ?"
            " ORDER BY created_at DESC LIMIT 200",
            (user_id,),
        ).fetchall()

        scored = []
        for content, created_at in rows:
            overlap = len(keywords & set(content.lower().split()))
            if overlap:
                scored.append((overlap + created_at / 1e15, content))
        scored.sort(reverse=True)
        return [content for _, content in scored[:limit]]

    def forget(self, snippet, user_id="default"):
        """Hapus fakta yang mengandung potongan teks."""
        cur = self.db.execute(
            "DELETE FROM facts WHERE user_id = ? AND content LIKE ?",
            (user_id, f"%{snippet}%"),
        )
        self.db.commit()
        return cur.rowcount
Cara memakainya dalam loop agent:
mem = SimpleMemory()

# setelah turn yang mengandung informasi penting
mem.remember("Pengguna lebih suka kursi lorong saat naik pesawat.")

# sebelum memanggil model di turn berikutnya
konteks = mem.recall("kursi pesawat apa yang disukai pengguna?")
prompt = "\n".join([
    "Ingatan relevan:",
    *[f"- {c}" for c in konteks],
    "",
    "Pesan pengguna: carikan penerbangan Jakarta-Surabaya.",
])
# kirim `prompt` ke model...
Contoh di atas sengaja sederhana — retrieval kata kunci gagal pada sinonim ("tiket" vs "penerbangan"). Di produksi, ganti tahap recall dengan pencarian semantik memakai embedding, misalnya lewat vector database seperti yang dibahas di perbandingan vector database. Anatominya tetap sama: tulis, simpan dengan metadata, baca kembali top-K.
Kalau kamu tidak mau membangun sendiri, Mem0 menyediakan pola yang sama sebagai SDK. Alurnya: kirim pesan ke add, panggil search sebelum request model berikutnya, dan putuskan sendiri memori mana yang masuk prompt (dokumentasi cara kerja Mem0):
from mem0 import Memory

m = Memory()  # konfigurasi default memakai OpenAI untuk embedding & LLM

m.add(
    [
        {"role": "user", "content": "Saya lebih suka duduk di kursi lorong."},
        {"role": "assistant", "content": "Dicatat, saya ingat preferensi itu."},
    ],
    user_id="panji",
)

hasil = m.search("kursi apa yang disukai pengguna?", user_id="panji")
print(hasil)
Perhatikan satu detail penting dari dokumentasi Mem0: secara default yang disimpan adalah fakta hasil ekstraksi, bukan transkrip mentah. Kalau kamu butuh menyimpan teks persis apa adanya, matikan inferensi saat add. Keputusan kecil seperti ini menentukan apakah memorimu berisi sinyal atau noise.
Mem0 vs Letta vs Zep: memilih pendekatan
Ketiga nama ini mewakili tiga filosofi berbeda. Tabel berikut merangkumnya supaya kamu bisa memilih dengan cepat:
| Aspek | Mem0 | Letta | Zep (Graphiti) |
|---|---|---|---|
| Filosofi | Lapisan memori drop-in: ekstrak fakta, simpan, cari | Agent mengelola memorinya sendiri seperti OS mengelola memori | Ingatan sebagai knowledge graph temporal |
| Siapa yang memutuskan apa diingat | Pipeline ekstraktor (LLM di belakang layar) | Agent itu sendiri lewat tool call | Pipeline ekstraksi ke graf |
| Penyimpanan | Vector store + key-value | Core (di konteks), recall, archival | Graf temporal + episodik |
| Kekuatan utama | Mudah dipasang, retrieval presisi per pengguna | Transparan, agent bisa belajar dan mengoreksi diri | Pertanyaan relasional dan historis ("kapan X berubah?") |
| Harga yang dibayar | Satu LLM call ekstra tiap add |
Lebih banyak tool call = latensi & biaya lebih tinggi | Setup dan query graf lebih kompleks |
| Lisensi inti | Apache 2.0, bisa self-host | Apache 2.0, bisa self-host | Apache 2.0 (mesin Graphiti) |
| Cocok untuk | Produk yang butuh ingatan lintas sesi dengan cepat | Agent otonom jangka panjang | Analitik percakapan dan konteks yang berubah seiring waktu |
Satu catatan jujur: ketiganya menyelesaikan masalah yang sama dari sudut berbeda, dan tidak ada yang "terbaik" secara absolut. Kalau kamu membangun fitur ingatan untuk aplikasi chat, Mem0 biasanya paling cepat menghasilkan. Kalau kamu membangun agent riset yang berjalan berminggu-minggu dan perlu merevisi pemahamannya sendiri, arsitektur Letta lebih cocok. Kalau pertanyaanmu selalu berbentuk "siapa memutuskan apa, kapan", graf temporal Zep menjawab paling natural.
Untuk fondasi teorinya, ada baiknya membaca dulu panduan RAG — retrieval memori agent pada dasarnya adalah RAG yang sumber dokumennya adalah pengalaman agent itu sendiri, bukan korpus statis.
Kesalahan umum dan cara menghindarinya
Menyimpan semuanya. Godaan terbesar sistem memori adalah mencatat setiap pesan. Hasilnya: database penuh noise, retrieval mengembalikan fakta basi, dan biaya ekstraksi membengkak. Tetapkan kebijakan tulis yang ketat — hanya fakta tentang pengguna, keputusan, preferensi, dan kejadian penting.
Tidak pernah melupakan. Fakta kedaluwarsa. Pengguna pindah kota, proyek ganti stack, preferensi berubah. Sistem memori tanpa mekanisme forget atau update perlahan menjadi arsip kebohongan yang dipercaya agent. Sediakan operasi hapus/perbarui sejak hari pertama, dan pertimbangkan TTL untuk fakta yang jelas sementara (misalnya status tugas).
Memori yang diracuni. Kalau agent menyimpan apa pun yang dikatakan pengguna tanpa verifikasi, penyerang bisa menyuntikkan "fakta" palsu lewat percakapan — misalnya mengklaim dirinya admin. Pisahkan memori yang berasal dari sumber tepercaya (konfigurasi, hasil tool) dan yang berasal dari ucapan pengguna, dan jangan biarkan yang kedua menimpa yang pertama tanpa konfirmasi.
Retrieval yang terlalu dermawan. Mengambil 30 kandidat "untuk jaga-jaga" hampir selalu merugikan: token membengkak dan model terganggu fakta marginal. Mulai dari top-3 sampai top-5, ukur kualitas jawaban, dan naikkan hanya kalau terbukti membantu.
Satu ember memori untuk semua pengguna. Lupa memisahkan memori per pengguna adalah bug privasi, bukan sekadar bug kualitas. Scope setiap operasi tulis dan baca dengan identitas yang jelas — pola user_id/agent_id/run_id ala Mem0 adalah contoh yang baik.
Menguji memori dengan satu sesi. Bug memori baru terlihat lintas waktu: fakta yang ditimpa diam-diam, ingatan yang tidak pernah terpanggil, duplikat yang menumpuk. Buat skenario uji multi-sesi: simpan fakta di sesi 1, ubah di sesi 2, verifikasi di sesi 3.
Best practice mendesain memori agent
- Mulai dari kebutuhan, bukan teknologi. Tulis dulu tiga pertanyaan yang harus bisa dijawab memorimu ("apa preferensi pengguna?", "keputusan apa yang sudah dibuat?"). Kalau jawabannya hanya butuh puluhan fakta, file teks biasa mengalahkan vector database.
- Pisahkan tulis dan baca. Kebijakan kapan menyimpan boleh longgar atau ketat, tapi kebijakan kapan mengambil harus selalu selektif. Keduanya di-tuning terpisah.
- Beri setiap fakta identitas dan waktu. Minimal: pemilik (user/agent/run), waktu dibuat, dan sumber (ucapan pengguna vs hasil tool vs konfigurasi). Tanpa ini, debugging memori adalah mimpi buruk.
- Sediakan operasi lupa sejak awal.
forgetdanupdatebukan fitur tambahan — mereka bagian dari definisi memori yang sehat. - Ukur, jangan percaya. Buat evaluasi kecil: 20–30 pertanyaan yang jawabannya bergantung pada ingatan lintas sesi, jalankan berkala. Kualitas retrieval menurun diam-diam seiring database membesar.
- Sederhana dulu, seperti nasihat Anthropic. Mulai dari pola paling sederhana yang menyelesaikan masalahmu, dan naikkan kompleksitas hanya kalau pengukuran membuktikan perlu. Agent yang baik lahir dari iterasi, bukan dari arsitektur paling canggih di hari pertama.
Prinsip terakhir ini juga berlaku untuk tooling agent secara umum — panduan MCP membahas cara memberi agent akses tool yang terdokumentasi baik, yang merupakan separuh lain dari persamaan agent selain memori.
FAQ
Apakah memori agent sama dengan context window?
Tidak. Context window adalah memori kerja sementara yang hilang saat sesi berakhir dan dibayar ulang setiap pemanggilan. Memori agent adalah sistem di sekitar model yang menyimpan informasi secara persisten dan memilih apa yang dimuat ke context window. Context window adalah salah satu konsumen memori, bukan memorinya sendiri.
Berapa lama memori agent bertahan?
Tergantung desainmu. Pola file dan database bertahan selama penyimpanannya ada — berminggu-minggu hingga bertahun-tahun. Yang kedaluwarsa bukan medianya, melainkan relevansi faktanya, karena itu mekanisme lupa dan perbarui sama pentingnya dengan mekanisme simpan.
Apakah cukup menyimpan seluruh riwayat percakapan?
Untuk sesi pendek, ya. Untuk pemakaian lintas sesi, tidak: mahal karena dibayar ulang setiap turn, berisik karena fakta penting tenggelam, dan tidak terstruktur sehingga sulit ditanya secara selektif. Ekstrak fakta pentingnya, simpan terstruktur, ambil yang relevan saja.
Bagaimana cara menghapus memori yang salah atau kedaluwarsa?
Sediakan operasi eksplisit sejak awal: hapus berdasarkan kecocokan teks atau ID, perbarui fakta yang berubah, dan terapkan TTL untuk informasi sementara. Pada pendekatan Letta, agent bisa melakukannya sendiri lewat tool; pada pendekatan pipeline, sediakan endpoint admin atau perintah khusus.
Apakah memori agent aman untuk data sensitif?
Hanya jika dirancang demikian. Pisahkan memori per pengguna dengan identitas yang tegas, jangan campur fakta dari sumber tepercaya dan ucapan pengguna tanpa label, enkripsi penyimpanan yang berisi PII, dan pastikan ada cara menghapus data pengguna secara tuntas saat diminta. Memori yang bocor antar pengguna adalah insiden privasi.
Kesimpulan
Memori AI agent bukan soal context window yang lebih besar — itu soal sistem yang memutuskan apa yang layak diingat, menyimpannya dalam bentuk yang bisa dicari, dan mengambil kembali hanya yang relevan. Tiga lapisan (jangka pendek, episodik, semantik) memberi kerangka berpikir; enam pola arsitektur memberi pilihan implementasi dari file teks sederhana sampai manajemen memori ala sistem operasi.
Langkah berikutnya yang paling masuk akal: ambil satu agent yang sudah kamu punya, tambahkan lapisan memori paling sederhana yang menyelesaikan satu masalah nyata — misalnya mengingat preferensi pengguna antar sesi — lalu ukur apakah jawabannya membaik. Kalau kamu membangun fondasi RAG-nya dulu lewat panduan RAG dan memahami keterbatasan context window dari panduan prompt engineering, menambah memori akan terasa seperti kelanjutan alami, bukan lompatan arsitektur.
Comments
Have a thought, a question, or something to add? Write it here.