Panduan Rate Limiting API: Token Bucket, Sliding Window, dan Implementasi Praktis
Panduan lengkap rate limiting API: empat algoritma, contoh kode Python dan Redis, konfigurasi NGINX, dan cara menangani 429 dengan benar.
Panji Ihsanudin Fajri
21 min read0 reads
Contents
- Apa itu rate limiting API?
- Kenapa rate limiting penting
- Empat algoritma rate limiting
- Fixed window counter
- Sliding window log
- Sliding window counter
- Token bucket
- Leaky bucket
- Perbandingan algoritma
- Memilih kunci dan granularitas batas
- Langkah demi langkah: implementasi token bucket di Python
- Langkah demi langkah: fixed window di Redis
- Menaruh batas di NGINX
- Header respons dan status 429 yang benar
- Rate limiting terdistribusi dan jebakannya
- Sisi klien: menangani 429 dengan benar
- Contoh nyata: bagaimana API publik mempublikasikan batasnya
- Kesalahan umum dan cara menghindarinya
- Best practice untuk produksi
- FAQ
- Apakah rate limiting dan throttling itu hal yang sama?
- Algoritma mana yang sebaiknya dipakai pertama kali?
- Berapa batas yang masuk akal untuk API baru?
- Apakah 429 harus dihitung sebagai error di monitoring?
- Apakah rate limiting cukup untuk menghentikan penyalahgunaan?
- Kesimpulan
Satu endpoint yang tidak dibatasi bisa dihabiskan oleh satu klien yang agresif: skrip yang lupa berhenti, integrasi yang retry tanpa jeda, atau bot yang meng-crawl tanpa ampun. Akibatnya bukan cuma server yang lambat, tapi pengguna lain ikut kena dampaknya. Artikel ini membahas rate limiting API dari dasar sampai implementasi: empat algoritma yang paling sering dipakai, kapan memakai masing-masing, contoh kode Python dan Redis, konfigurasi NGINX, dan cara klien yang baik menangani respons 429.
Ringkasan: Rate limiting membatasi jumlah request per klien dalam satu jendela waktu. Fixed window paling sederhana tapi punya efek burst di batas jendela. Sliding window lebih halus tapi lebih mahal dihitung. Token bucket mengizinkan burst terkendali, leaky bucket memaksakan laju keluar yang konstan. Untuk sistem multi-instance, simpan counter di store bersama seperti Redis. Selalu kembalikan 429 dengan header Retry-After, bukan 403 atau 503.
Apa itu rate limiting API?
Rate limiting API adalah pembatasan jumlah request yang diterima dari satu klien dalam periode tertentu. Satu klien di sini bisa berarti satu alamat IP, satu API key, satu akun pengguna, atau satu kombinasi dari ketiganya. Batasnya dinyatakan sebagai angka dan jendela waktu, misalnya 100 request per menit atau 1.000 request per jam.
Ketika klien melewati batas, server menolak request berikutnya sampai jendela berikutnya dimulai. Penolakan ini harus eksplisit: status 429 Too Many Requests plus header Retry-After yang memberi tahu klien berapa lama harus menunggu. Klien yang tidak diberi tahu kapan boleh mencoba lagi akan terus mencoba, dan retry yang membabi buta justru menambah beban yang ingin dicegah.
Rate limiting berbeda dari throttling dalam satu hal yang sering dicampuradukkan. Rate limiting menolak request yang melebihi kuota. Throttling memperlambat pemrosesan request tanpa harus menolaknya. Keduanya mengatur beban, tapi efeknya ke klien berbeda: yang satu mendapat respons gagal yang jelas, yang satu lagi mendapat respons lambat. Artikel ini fokus ke rate limiting, dengan throttling disinggung hanya sebagai alternatif di bagian perbandingan.
Satu hal yang perlu diluruskan sejak awal: rate limiting bukan pengganti autentikasi atau otorisasi. Request dari klien yang tidak dikenal tetap bisa dibatasi berdasarkan IP, tapi batas berbasis IP tidak pernah seakurat batas berbasis API key. IP bersama, seperti NAT kantor atau jaringan seluler, membuat banyak pengguna terlihat sebagai satu klien. Karena itu, API publik yang serius hampir selalu membatasi berdasarkan API key atau akun, dan memakai batas berbasis IP hanya sebagai lapisan luar.
Kenapa rate limiting penting
Alasan pertama adalah perlindungan terhadap beban yang tidak wajar. Satu endpoint berat, misalnya pencarian dengan banyak filter atau laporan yang memindai ribuan baris, bisa menghabiskan koneksi database kalau dipanggil ribuan kali per menit. Batas yang masuk akal mengubah masalah ini dari "server down" menjadi "satu klien mendapat 429". Pengguna lain tetap bisa memakai API.
Alasan kedua adalah keadilan antar klien. Tanpa batas, klien yang paling agresif mengambil porsi terbesar dari kapasitas yang terbatas. Ini terasa nyata di API multi-tenant: satu tenant yang menjalankan backfill besar-besaran bisa memperlambat tenant lain yang hanya memakai API untuk operasional harian. Batas per tenant menjaga agar tidak ada satu pihak yang memonopoli sumber daya bersama.
Alasan ketiga adalah biaya. Banyak beban API diterjemahkan langsung ke tagihan: komputasi, query database, panggilan ke model AI, atau layanan pihak ketiga yang ditagih per request. Rate limiting adalah rem darurat yang murah. Lebih baik menolak request ke-10.001 dalam satu jam daripada membayar lonjakan yang disebabkan skrip yang salah konfigurasi.
Alasan keempat adalah keamanan dasar. Rate limiting tidak menghentikan serangan yang serius, tapi mempersempit ruang geraknya. Endpoint login dan reset password adalah contoh klasik: membatasi percobaan per akun dan per IP membuat brute force menjadi jauh lebih lambat dan lebih mudah dideteksi. Untuk endpoint semacam ini, batasnya harus jauh lebih ketat daripada batas endpoint baca biasa, dan kegagalan autentikasi harus tetap dihitung meskipun responsnya generik.
Alasan kelima, yang sering dilupakan, adalah kontrak dengan klien. Batas yang dipublikasikan dan header kuota yang konsisten membuat integrasi bisa direncanakan. Developer yang mengintegrasikan API kamu bisa menghitung berapa banyak request yang mereka butuhkan, kapan mereka harus memakai cache, dan kapan mereka harus meminta kenaikan kuota. API yang tiba-tiba menolak request tanpa penjelasan merusak kepercayaan lebih cepat daripada API yang menolak dengan batas yang jelas.
Empat algoritma rate limiting
Fixed window counter
Fixed window adalah algoritma paling sederhana. Server menyimpan counter per klien per jendela waktu yang tetap, misalnya per menit kalender. Setiap request menaikkan counter. Kalau counter sudah mencapai batas, request ditolak sampai jendela berikutnya dimulai dan counter di-reset ke nol.
Implementasinya murah: satu operasi increment di Redis plus expiry. Kelemahannya adalah efek burst di batas jendela. Klien bisa mengirim 100 request di detik terakhir menit pertama dan 100 request lagi di detik pertama menit kedua, sehingga dalam dua detik ia mengirim 200 request padahal batasnya 100 per menit. Untuk banyak kasus ini masih bisa diterima, terutama untuk batas yang longgar. Untuk endpoint sensitif seperti login, kelemahan ini cukup untuk memilih algoritma lain.
Sliding window log
Sliding window log menyimpan timestamp setiap request dari satu klien, lalu menghitung berapa banyak timestamp yang masih berada di dalam jendela berjalan. Request baru ditolak kalau jumlahnya sudah mencapai batas. Algoritma ini akurat: tidak ada celah burst di batas jendela, karena jendelanya selalu bergerak mengikuti waktu sekarang.
Harganya adalah memori dan komputasi. Menyimpan timestamp per request berarti data tumbuh sebanding dengan jumlah request, dan setiap keputusan butuh membaca lalu memangkas daftar timestamp lama. Untuk API dengan trafik tinggi, biayanya terasa. Karena itu sliding window log biasanya dipakai di endpoint yang jumlah request-nya moderat tapi akurasinya penting, bukan di semua endpoint.
Sliding window counter
Sliding window counter adalah kompromi antara keduanya. Jendela waktu dibagi menjadi slot-slot kecil, misalnya satu menit dibagi menjadi enam slot sepuluh detik. Counter per slot dijumlahkan dengan bobot: slot yang sedang berjalan dihitung penuh, slot sebelumnya dihitung proporsional sesuai sisa waktunya. Hasilnya mendekati sliding window log tanpa harus menyimpan timestamp per request.
Algoritma ini cukup populer di gateway dan library rate limiting karena akurasinya bagus dengan biaya yang rendah. Kelemahannya, ia tetap aproksimasi. Dalam kasus ekstrem, hitungannya bisa sedikit meleset dari jumlah request sebenarnya di jendela berjalan. Untuk hampir semua kebutuhan API publik, selisih itu tidak berarti.
Token bucket
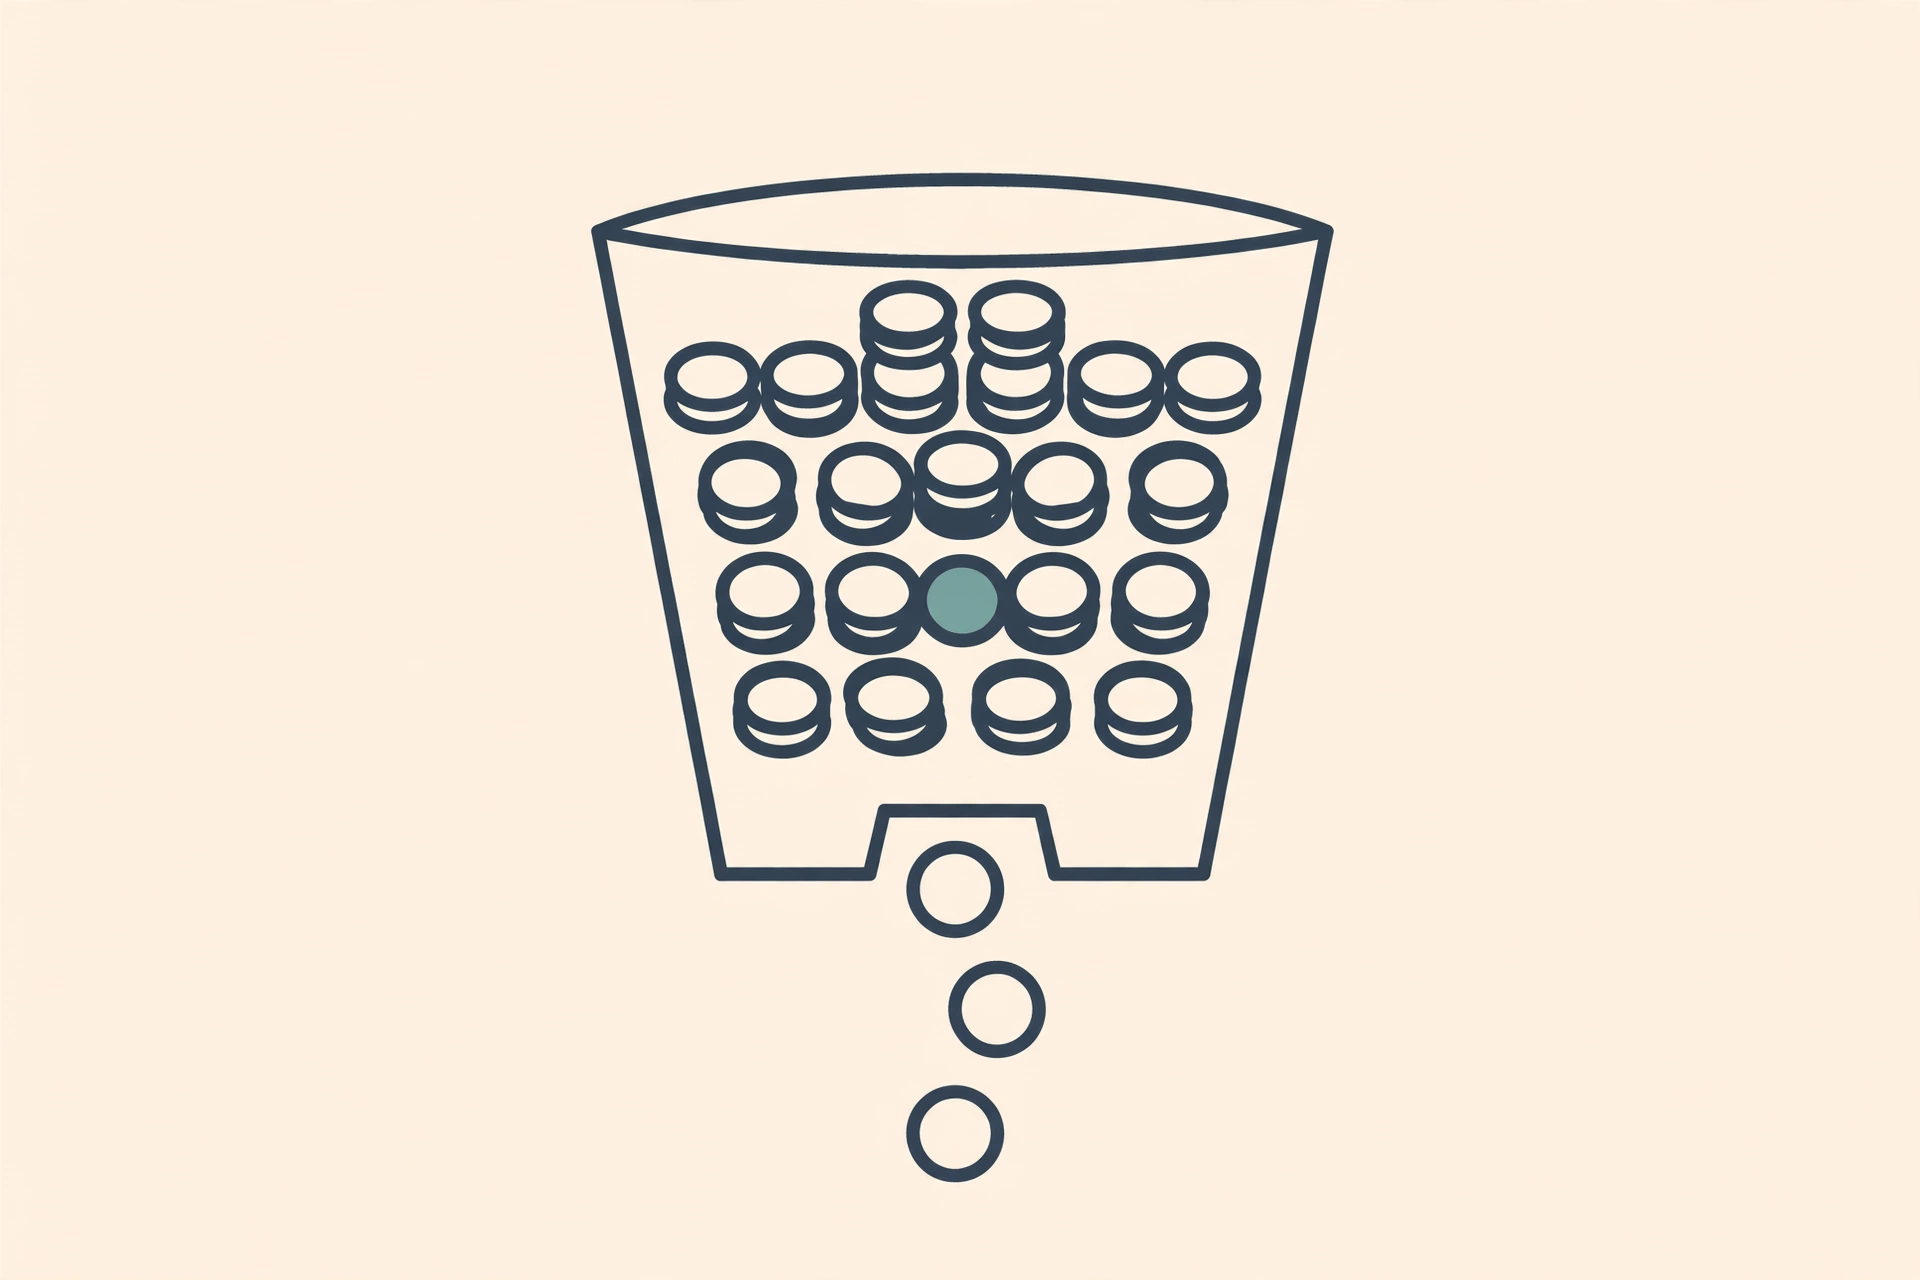
Token bucket bekerja seperti ember yang diisi token dengan laju tetap. Setiap request mengambil satu token. Kalau ember kosong, request ditolak sampai token terisi lagi. Kapasitas ember menentukan seberapa besar burst yang diizinkan: ember berkapasitas 100 yang terisi penuh mengizinkan 100 request seketika, lalu laju pengisian membatasi request berikutnya.
Ini adalah algoritma yang paling fleksibel untuk API umum. Ia mengizinkan burst sesekali, yang wajar untuk pola trafik manusia dan batch job, tapi tetap membatasi laju rata-rata dalam jangka panjang. Hampir semua diskusi tentang rate limiting API bermuara ke token bucket karena perilakunya mudah dipahami dan mudah disetel: dua angka, kapasitas dan laju isi ulang, sudah cukup menggambarkan kebijakan.
Leaky bucket
Leaky bucket adalah cerminan token bucket. Request masuk ke antrean, lalu dikeluarkan dari antrean dengan laju konstan, seperti ember yang bocor dengan kecepatan tetap. Kalau antrean penuh, request baru ditolak. Hasilnya adalah aliran keluar yang sangat halus: tidak ada burst sama sekali, berapapun pola request yang masuk.
Kelebihan ini sekaligus kelemahannya. Leaky bucket bagus untuk melindungi sistem downstream yang tidak tahan lonjakan, misalnya antrean pemrosesan atau layanan pihak ketiga dengan kuota ketat. Tapi untuk API yang melayani pengguna interaktif, perilaku ini terasa kaku: request yang sebenarnya masih dalam kuota rata-rata bisa tertunda atau ditolak hanya karena datang berdekatan. Dalam praktik, token bucket lebih sering dipilih untuk API publik, sementara leaky bucket dipakai di lapisan pemrosesan internal.
Perbandingan algoritma
| Aspek | Fixed window | Sliding window | Token bucket | Leaky bucket |
|---|---|---|---|---|
| Akurasi | Rendah di batas jendela | Tinggi | Tinggi untuk laju rata-rata | Tinggi, laju keluar konstan |
| Burst | Diizinkan penuh di batas jendela | Tidak | Diizinkan sampai kapasitas ember | Tidak pernah |
| Biaya memori | Satu counter | Timestamp per request | Satu counter + timestamp | Satu antrean |
| Kompleksitas implementasi | Sangat rendah | Sedang | Rendah | Sedang |
| Cocok untuk | Batas longgar, endpoint baca | Endpoint sensitif, trafik moderat | API publik umum | Downstream yang rapuh |
Tabel ini bukan aturan kaku. Banyak sistem produksi menggabungkan beberapa algoritma sekaligus: fixed window di edge untuk perlindungan kasar, token bucket per API key di gateway untuk kebijakan produk, dan batas ketat khusus di endpoint login. Lapisan-lapisan ini saling melengkapi, bukan saling menggantikan.
Memilih kunci dan granularitas batas
Algoritma hanya setengah dari desain. Setengah lainnya adalah menjawab: batas ini berlaku untuk siapa, dan untuk apa. Pilihan yang salah membuat batas yang secara teknis benar menjadi tidak adil atau tidak berguna.
Batas berbasis IP adalah lapisan paling luar. Ia murah, tidak butuh autentikasi, dan berguna untuk memblokir pola kasar seperti satu IP yang mengirim ribuan request per detik. Kelemahannya sudah disebut: NAT dan proxy bersama membuat satu IP mewakili banyak manusia. Jangan pernah memakai batas IP sebagai satu-satunya batas untuk API yang sudah punya autentikasi.
Batas berbasis API key atau akun adalah lapisan utama untuk API publik. Satu kunci, satu kuota. Kunci yang bocor atau disalahgunakan bisa dicabut tanpa memengaruhi pengguna lain. Kalau API kamu punya tier gratis dan berbayar, di sinilah tier itu diwujudkan: kunci gratis mendapat 100 request per jam, kunci berbayar mendapat 10.000 request per jam, dan seterusnya.
Batas per endpoint menambah presisi. Endpoint baca yang murah bisa punya batas longgar, sementara endpoint tulis yang mahal atau endpoint yang memicu pekerjaan berat mendapat batas ketat. Endpoint login, reset password, dan kirim OTP adalah kategori sendiri: batasnya dihitung per akun dan per IP secara bersamaan, karena menyerang akun tertentu dari banyak IP adalah pola yang nyata.
Granularitas yang terlalu halus juga punya biaya. Setiap kombinasi kunci dan endpoint adalah satu counter yang harus disimpan dan dihitung. Mulailah dari tiga lapisan: IP di edge, API key di gateway, dan batas khusus untuk segelintir endpoint sensitif. Tambah lapisan baru hanya ketika ada masalah nyata yang terlihat di metrik, bukan karena khawatir akan masalah hipotetis.
Langkah demi langkah: implementasi token bucket di Python
Contoh berikut adalah token bucket in-memory yang cukup untuk satu proses. Ia memakai lock agar aman dipakai dari banyak thread, dan mengisi ulang token berdasarkan waktu yang berlalu, bukan dengan timer latar belakang.
import threading
import time


class TokenBucket:
    def __init__(self, capacity: int, refill_per_second: float):
        self.capacity = capacity
        self.tokens = float(capacity)
        self.refill_per_second = refill_per_second
        self.last_refill = time.monotonic()
        self.lock = threading.Lock()

    def _refill(self, now: float) -> None:
        elapsed = now - self.last_refill
        self.tokens = min(self.capacity, self.tokens + elapsed * self.refill_per_second)
        self.last_refill = now

    def allow(self, cost: int = 1) -> bool:
        with self.lock:
            now = time.monotonic()
            self._refill(now)
            if self.tokens >= cost:
                self.tokens -= cost
                return True
            return False
Memakai kelas ini di handler request hanya butuh satu pengecekan sebelum logika utama berjalan. Kalau allow() mengembalikan False, handler langsung mengembalikan 429. Satu detail penting: pakai time.monotonic(), bukan waktu dinding, karena waktu dinding bisa melompat maju atau mundur saat jam sistem disinkronkan, dan lompatan itu akan mengacaukan perhitungan isi ulang.
Versi in-memory ini punya batas yang jelas: setiap proses punya ember sendiri. Aplikasi dengan dua instance berarti kapasitas efektifnya dua kali lipat. Selama masih satu proses dan trafiknya kecil, ini cukup. Begitu aplikasi berjalan di banyak instance, counter harus pindah ke store bersama.
Langkah demi langkah: fixed window di Redis
Redis adalah pilihan paling umum untuk store bersama karena operasinya atomik dan cepat. Pola fixed window memakai INCR untuk menaikkan counter dan EXPIRE untuk memastikan kunci hilang saat jendela berakhir. Skrip Lua membuat kedua langkah itu atomik, sehingga tidak ada kondisi balapan antara pengecekan dan penambahan.
local current = redis.call("INCR", KEYS[1])
if current == 1 then
    redis.call("EXPIRE", KEYS[1], ARGV[1])
end
return current
Dari sisi aplikasi, alurnya seperti ini: jalankan skrip dengan kunci ratelimit:{api_key}:{menit_sekarang} dan TTL 60 detik. Kalau nilai yang dikembalikan lebih besar dari batas, tolak dengan 429. Kalau tidak, lanjutkan. Kunci yang memuat menit sekarang membuat jendela bergeser otomatis tanpa pekerjaan bersih-bersih.
Pola ini juga menunjukkan kenapa Redis dipilih: satu round trip, satu operasi atomik, dan tidak ada state lokal yang perlu disinkronkan antar instance. Kekurangannya sama dengan fixed window pada umumnya, yaitu efek burst di batas jendela. Kalau itu menjadi masalah, ganti skripnya dengan sliding window berbasis sorted set, atau pakai library rate limiting yang sudah menangani detail itu.
Menaruh batas di NGINX
Tidak semua batas harus ditulis di kode aplikasi. NGINX punya modul limit_req yang membatasi laju request sebelum request mencapai aplikasi sama sekali. Ini adalah tempat yang tepat untuk batas kasar berbasis IP.
limit_req_zone $binary_remote_addr zone=api_limit:10m rate=10r/s;

server {
    location /api/ {
        limit_req zone=api_limit burst=20 nodelay;
        limit_req_status 429;
        proxy_pass http://backend;
    }
}
Konfigurasi ini mengizinkan rata-rata 10 request per detik per IP, dengan burst sampai 20 request sekaligus. Dua detail di sini penting dan sering terlewat. Pertama, NGINX secara default mengembalikan 503 untuk request yang dibatasi, bukan 429. Baris limit_req_status 429 memperbaikinya. Kedua, burst tanpa nodelay berarti request berlebih diantrekan dan diproses perlahan, bukan ditolak langsung. Tambahkan nodelay kalau kamu memang ingin menolak, bukan mengantrekan.
Batas di NGINX dan batas di aplikasi bukan pilihan yang saling meniadakan. NGINX melindungi dari pola kasar dengan biaya nyaris nol. Aplikasi menerapkan kebijakan produk yang butuh konteks: tier akun, endpoint, dan kuota per kunci. Keduanya berjalan di lapisan yang berbeda dan gagal secara independen, dan itu justru bagus.
Header respons dan status 429 yang benar
Bagian yang paling sering diabaikan dari rate limiting adalah komunikasinya. Klien yang baik bisa menyesuaikan diri, tapi hanya kalau server memberi informasi yang cukup. Minimal, setiap respons yang ditolak harus membawa tiga hal: status 429, header Retry-After berisi jumlah detik sampai boleh mencoba lagi, dan body yang menjelaskan batas mana yang terlampaui.
Status 429 didefinisikan di RFC 6585. Header Retry-After bisa berisi jumlah detik atau tanggal HTTP, dan klien harus menghormati nilai itu sebelum mencoba lagi. Jangan mengembalikan 403 untuk kasus ini: 403 berarti klien tidak diizinkan secara permanen, dan klien yang membaca 403 akan berhenti atau melaporkan kesalahan autentikasi, bukan menunggu. Jangan pula mengembalikan 503: 503 berarti server bermasalah, padahal server baik-baik saja dan hanya satu klien yang melebihi kuota.
Selain respons penolakan, kirim juga header kuota di respons sukses. Konvensi lama memakai X-RateLimit-Limit, X-RateLimit-Remaining, dan X-RateLimit-Reset. Draf standar IETF untuk header RateLimit menstandarkan bentuk tanpa prefix X-: RateLimit-Limit, RateLimit-Remaining, RateLimit-Reset, dan RateLimit-Policy. Selama masa transisi, mengirim kedua bentuk sekaligus adalah pilihan yang aman: klien lama tetap membaca bentuk X-, klien baru bisa memakai bentuk standar. Yang tidak boleh berubah-ubah adalah maknanya. RateLimit-Reset di bentuk standar berarti detik sampai reset, sementara X-RateLimit-Reset di banyak API berarti timestamp Unix. Dokumentasikan mana yang kamu kirim, dan jangan mencampur keduanya dalam satu header.
Rate limiting terdistribusi dan jebakannya
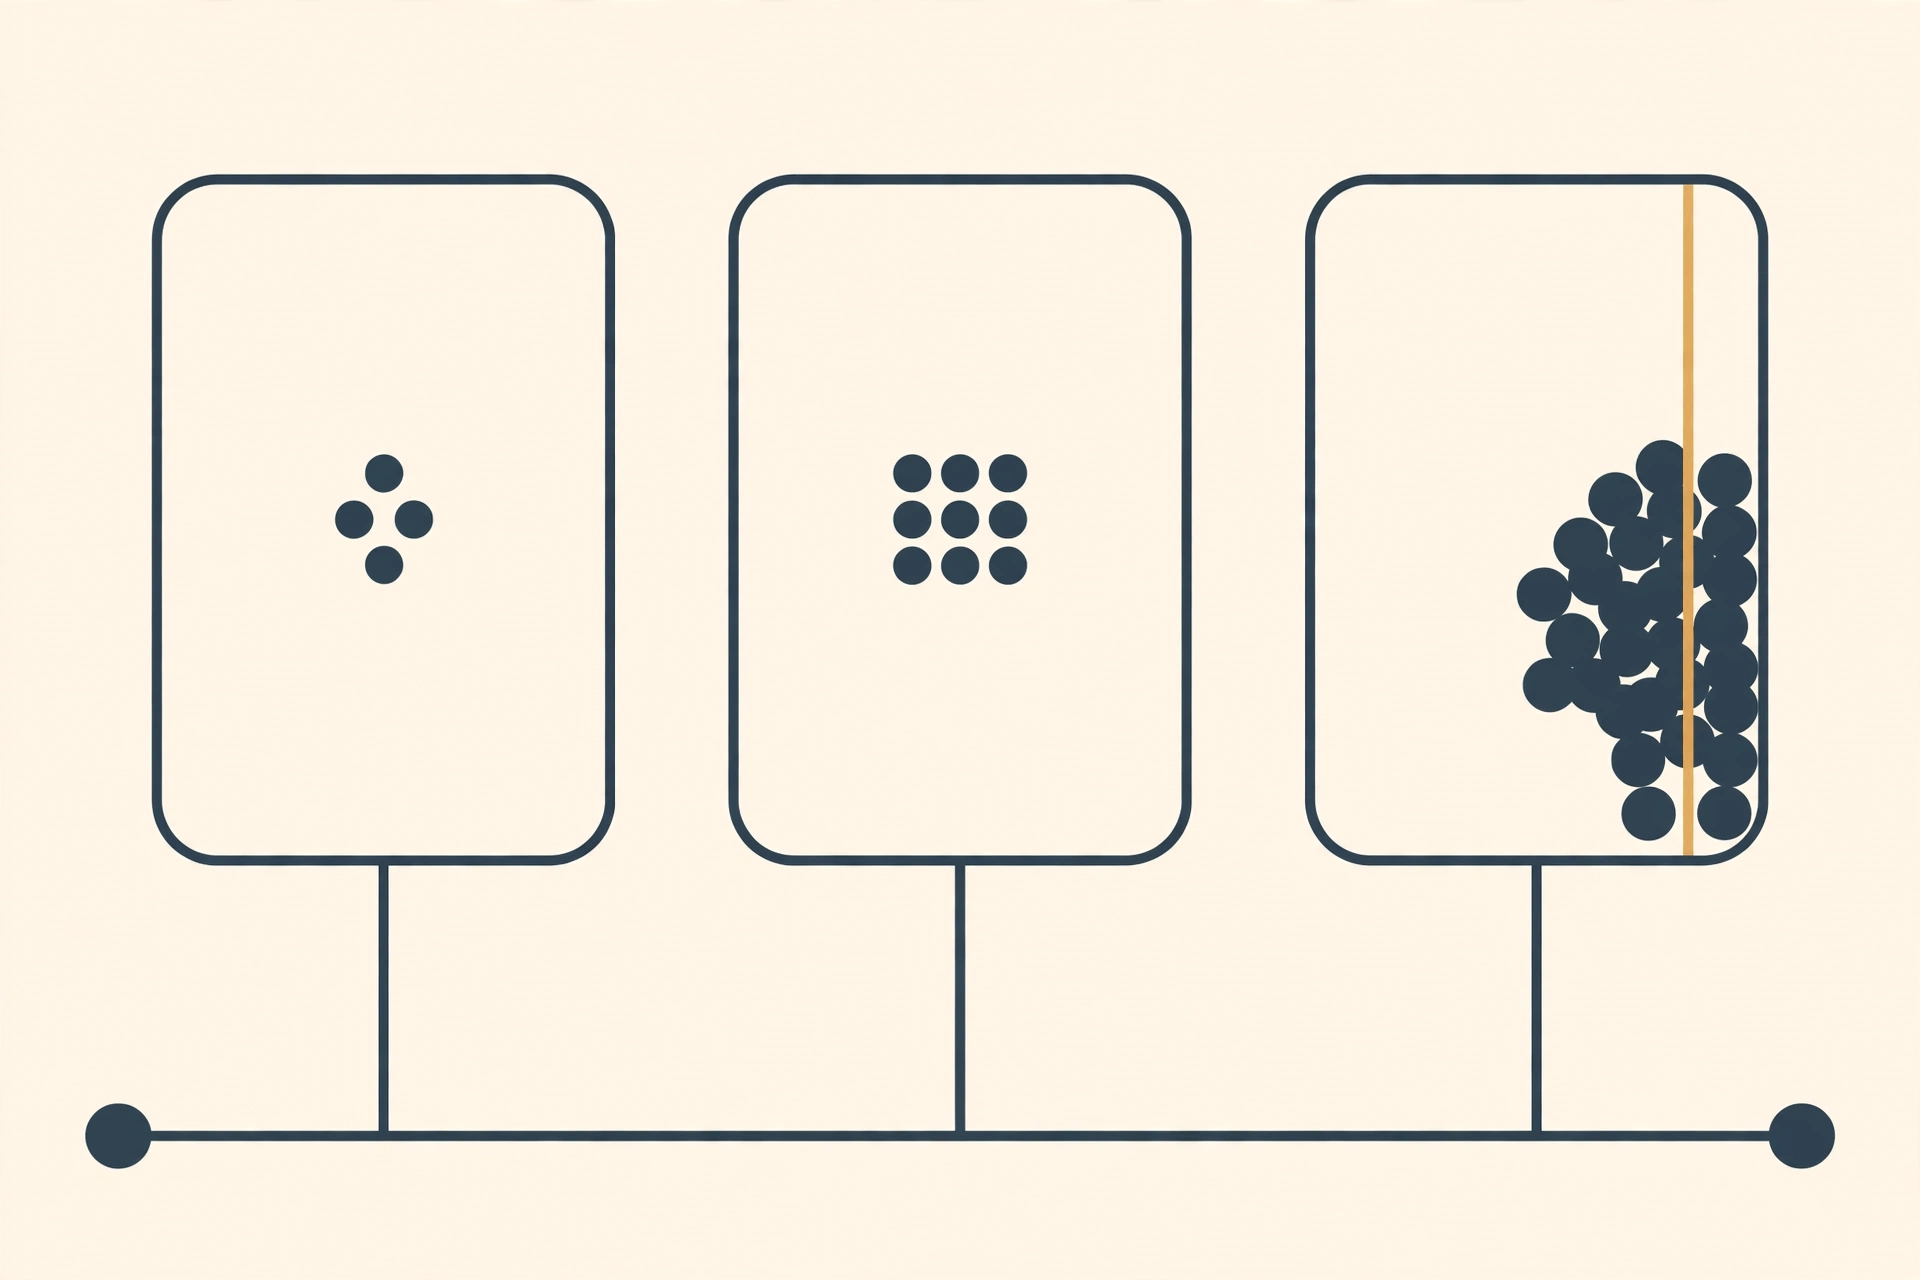
Begitu aplikasi berjalan di banyak instance, semua keputusan harus melihat counter yang sama. Inilah alasan Redis, atau store bersama lainnya, menjadi standar. Tapi memindahkan counter ke store bersama memunculkan tiga jebakan yang perlu diantisipasi sejak awal.
Jebakan pertama adalah kondisi balapan. Dua request yang datang bersamaan ke dua instance berbeda bisa sama-sama membaca counter "99 dari 100" lalu sama-sama lolos, sehingga batas 100 dilanggar. Solusinya adalah operasi atomik: increment dan pengecekan harus terjadi dalam satu langkah di sisi store, seperti skrip Lua di atas, bukan baca lalu tulis dari aplikasi.
Jebakan kedua adalah kegagalan store. Kalau Redis mati, apa yang terjadi pada API? Ada dua jawaban, dan keduanya punya konsekuensi. Fail open berarti API tetap melayani tanpa batas selama store mati: pengguna tidak terganggu, tapi perlindungan hilang tepat saat sistem sedang bermasalah. Fail closed berarti semua request ditolak selama store mati: perlindungan utuh, tapi satu kegagalan Redis berubah menjadi outage API. Kebanyakan API publik memilih fail open dengan alarm yang keras, karena outage total lebih mahal daripada jendela tanpa batas yang singkat. Apapun pilihanmu, buat keputusan ini secara sadar dan dokumentasikan, jangan biarkan terjadi secara kebetulan lewat exception yang tidak tertangani.
Jebakan ketiga adalah jam dan kunci yang tidak konsisten. Counter per menit kalender mengasumsikan semua instance sepakat soal "menit sekarang". Perbedaan jam beberapa detik antar instance biasanya tidak berarti, tapi kunci yang memakai IP dari header X-Forwarded-For tanpa validasi adalah masalah nyata: header itu bisa dipalsukan klien, sehingga penyerang bisa berpura-pura menjadi banyak IP berbeda. Ambil IP dari koneksi langsung atau dari proxy tepercaya yang kamu kontrol, dan perlakukan header forwarded sebagai data yang tidak tepercaya kecuali kamu memang mengonfigurasi proxy untuk menimpanya.
Sisi klien: menangani 429 dengan benar
Rate limiting adalah kontrak dua arah. Server memberi batas dan sinyal, klien menghormati sinyal itu. Klien yang baik membaca header Retry-After dan menunggu selama itu sebelum mencoba lagi. Klien yang buruk mengabaikannya dan retry secepat mungkin, yang justru memperpanjang masa penolakan dan menambah beban.
Pola retry yang sehat memakai backoff eksponensial dengan jitter. Tunggu 1 detik, lalu 2, lalu 4, dan seterusnya, dengan sedikit acak di setiap jeda supaya ribuan klien yang ditolak bersamaan tidak bangun dan menyerbu di detik yang sama persis. Jitter ini penting: tanpa acak, retry yang tersinkronisasi menciptakan gelombang trafik baru yang persis seperti masalah yang ingin dihindari.
import random
import time


def call_with_retry(call, max_attempts=5):
    delay = 1.0
    for attempt in range(max_attempts):
        status, retry_after = call()
        if status != 429:
            return status
        wait = float(retry_after) if retry_after else delay
        time.sleep(wait + random.uniform(0, wait * 0.25))
        delay = min(delay * 2, 60.0)
    return 429
Fungsi ini memakai Retry-After dari server kalau tersedia, dan jatuh kembali ke backoff kalau tidak. Batas percobaan juga penting: retry tanpa batas mengubah kegagalan sementara menjadi beban permanen. Lima kali percobaan dengan jeda yang membesar sudah cukup untuk sebagian besar kasus; kalau masih gagal, laporkan kegagalan ke atas, jangan diam-diam mencoba selamanya.
Klien yang lebih canggih tidak menunggu sampai kena 429. Mereka membaca header kuota di respons sukses dan memperlambat diri sendiri saat Remaining menipis. Ini adalah perilaku yang membedakan integrasi yang matang dari integrasi yang sekadar jalan: yang satu merencanakan pemakaian kuotanya, yang satu lagi menabrak dinding lalu mengeluh.
Contoh nyata: bagaimana API publik mempublikasikan batasnya
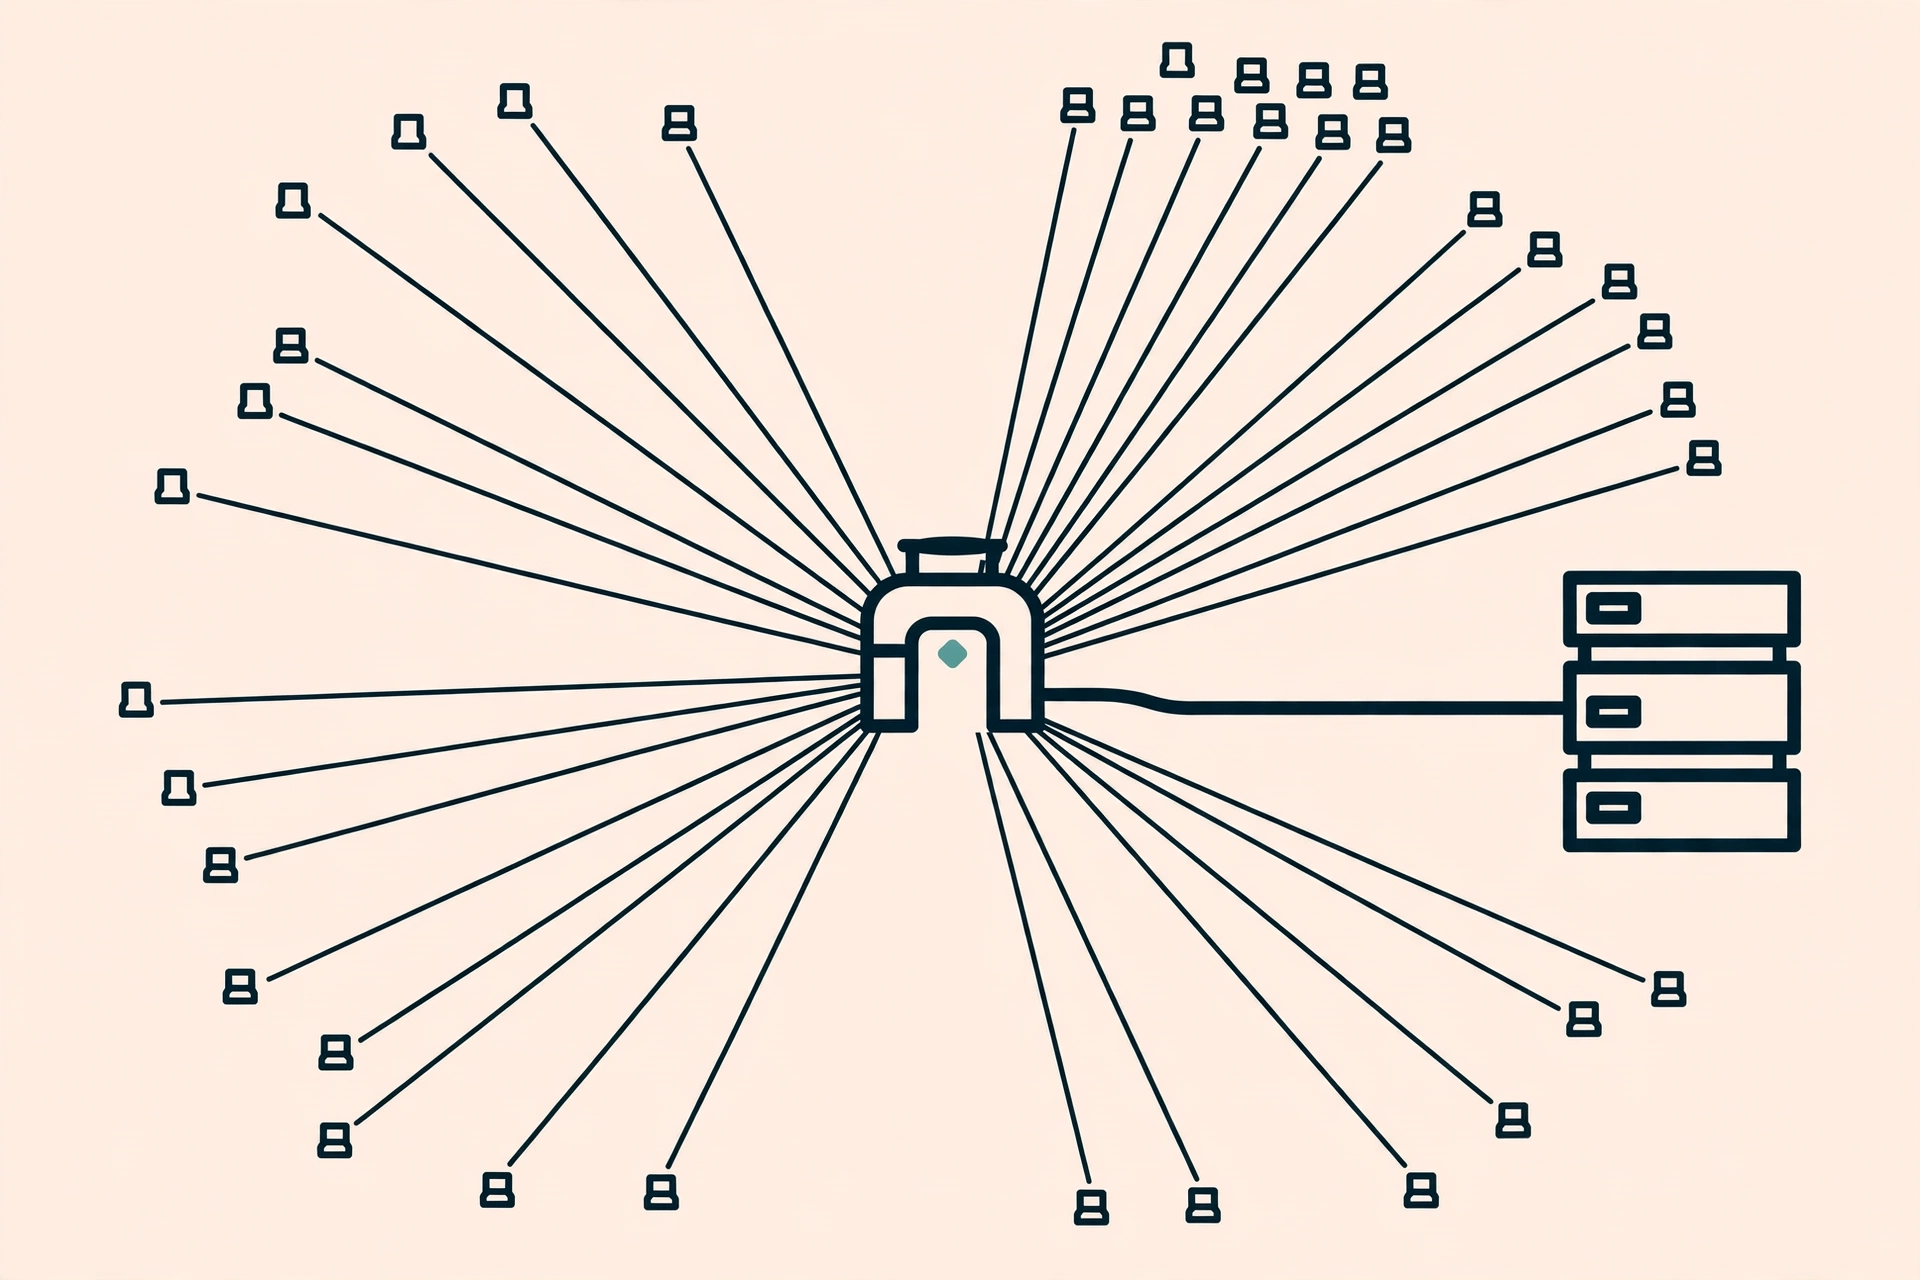
API publik yang besar hampir selalu mempublikasikan batasnya secara terbuka, karena batas yang tersembunyi menghasilkan integrasi yang rapuh. GitHub, misalnya, mempublikasikan batas berbeda untuk request tanpa autentikasi dan dengan autentikasi, dan mengembalikan header kuota di setiap respons. Pola ini bisa ditiru di API sekecil apapun: satu halaman dokumentasi yang menyatakan angka batas per tier, plus header yang konsisten di setiap respons.
Pelajaran dari contoh ini bukan angkanya, karena angka setiap API berbeda dan berubah seiring waktu. Pelajarannya adalah transparansinya. Developer yang tahu batasnya bisa memakai cache untuk request yang berulang, menggabungkan banyak operasi ke endpoint batch, dan menjadwalkan pekerjaan berat di luar jam sibuk. Semua perilaku baik ini muncul bukan karena klien dipaksa, tapi karena mereka diberi informasi yang cukup untuk memutuskan sendiri. Panduan tentang desain REST API dan strategi caching dengan Redis di blog ini membahas dua pelengkap rate limiting yang paling sering dipakai bersamaan: desain endpoint yang baik mengurangi jumlah request yang diperlukan, dan cache mengurangi jumlah request yang benar-benar sampai ke server.
Kesalahan umum dan cara menghindarinya
Kesalahan pertama adalah membatasi setelah pekerjaan berat dilakukan. Middleware rate limiting harus berjalan sebelum handler yang mahal: sebelum query database, sebelum memanggil layanan pihak ketiga, sebelum merender laporan. Batas yang dicek setelah pekerjaan selesai tidak melindungi apa-apa, ia hanya menambah satu pengecekan ke beban yang sudah terjadi.
Kesalahan kedua adalah satu batas global untuk semua endpoint. Batas global 1.000 request per jam mungkin longgar untuk endpoint baca tapi sangat ketat untuk endpoint yang dipanggil dalam loop sinkronisasi, atau sebaliknya. Akibatnya, satu endpoint yang rakus menghabiskan kuota yang dibutuhkan endpoint lain. Pisahkan batas per endpoint untuk segelintir endpoint yang perilakunya berbeda jauh dari rata-rata.
Kesalahan ketiga adalah mengembalikan status yang salah. Sudah dibahas di atas, tapi layak diulang karena sangat sering terjadi: 403 untuk klien yang melebihi kuota membuat klien mengira kredensialnya bermasalah, dan 503 membuat sistem monitoring mengira server sedang down. Gunakan 429, sertakan Retry-After, dan tulis body yang menyebut batas mana yang terlampaui.
Kesalahan keempat adalah tidak menguji batasnya. Rate limiting yang tidak pernah diuji cenderung salah di kedua arah: terlalu longgar sehingga tidak melindungi, atau terlalu ketat sehingga memblokir pengguna sah di hari pertama. Uji dengan skrip sederhana: kirim request sedikit di atas batas dan pastikan respons ke-101 adalah 429 dengan header yang benar, lalu tunggu sampai jendela bergulir dan pastikan request kembali diterima. Uji juga perilaku saat store mati, sesuai keputusan fail open atau fail closed yang sudah kamu pilih.
Kesalahan kelima adalah melupakan pengguna di balik NAT dan proxy bersama. Batas per IP yang terlalu ketat akan memblokir satu kantor atau satu kampus sekaligus karena mereka berbagi satu IP keluar. Kalau keluhan "API tiba-tiba menolak semua request kami" datang dari satu organisasi, hampir pasti ini penyebabnya. Solusinya adalah batas per API key sebagai lapisan utama, dengan batas per IP yang longgar sebagai jaring pengaman saja.
Best practice untuk produksi
Mulai dari kebijakan yang bisa dijelaskan dalam satu kalimat: siapa yang dibatasi, berapa batasnya, dan dalam jendela apa. Kalau kebijakanmu butuh satu paragraf untuk dijelaskan, ia terlalu rumit dan akan sulit dioperasikan. Tiga lapisan adalah titik awal yang sehat: batas longgar per IP di edge, batas per API key di gateway, dan batas ketat untuk endpoint sensitif.
Dokumentasikan batasnya di tempat yang sama dengan dokumentasi API lainnya, dan perlakukan perubahan batas sebagai perubahan API yang perlu dikomunikasikan. Klien yang tiba-tiba mendapat 429 setelah bertahun-tahun aman akan menganggapnya bug, kecuali mereka sudah diberi tahu bahwa batas berubah dan kapan berubahnya.
Pantau metrik rate limiting seperti metrik lainnya. Yang perlu dilihat: berapa persen request yang ditolak per endpoint, klien mana yang paling sering ditolak, dan apakah penolakan berkorelasi dengan lonjakan latensi atau error di downstream. Penolakan yang naik tiba-tiba bisa berarti serangan, bug di klien populer, atau batas yang terlalu ketat setelah rilis baru. Tanpa metrik ini, kamu hanya bisa menebak. Hubungkan juga dengan observabilitas yang sudah ada: panduan OpenTelemetry di blog ini menunjukkan cara membawa metrik semacam ini ke satu tempat yang sama dengan trace dan log.
Terakhir, uji beban sebelum mengandalkan batas di produksi. Rate limiting yang hanya diuji dengan puluhan request per detik bisa runtuh pada ribuan request per detik, bukan karena algoritmanya salah, tapi karena store-nya menjadi bottleneck baru. Uji dengan trafik yang mendekati puncak yang kamu harapkan, dan ukur latensi tambahan dari pengecekan batas itu sendiri. Pengecekan yang menambah 50 milidetik ke setiap request adalah pajak yang dibayar semua pengguna, termasuk yang tidak pernah mendekati batas.
FAQ
Apakah rate limiting dan throttling itu hal yang sama?
Tidak. Rate limiting menolak request yang melebihi kuota dengan respons 429. Throttling memperlambat pemrosesan request tanpa menolaknya. Keduanya mengatur beban, tapi klien merasakan hasil yang berbeda: gagal cepat atau lambat. Banyak sistem memakai keduanya di lapisan berbeda.
Algoritma mana yang sebaiknya dipakai pertama kali?
Untuk API publik umum, token bucket. Ia punya dua parameter yang mudah dipahami, mengizinkan burst yang wajar, dan membatasi laju rata-rata. Pakai fixed window kalau kesederhanaan lebih penting daripada akurasi di batas jendela, dan sliding window kalau akurasi di batas jendela adalah syarat, misalnya di endpoint login.
Berapa batas yang masuk akal untuk API baru?
Tidak ada angka universal. Mulailah dari pola pakai yang kamu amati: ukur request per klien per jam di trafik normal, lalu tetapkan batas beberapa kali lipat di atas puncak normal itu. Batas yang terlalu ketat di hari pertama akan memblokir pengguna sah; batas yang longgar masih bisa diketatkan setelah kamu punya data. Yang penting, publikasikan angkanya dan pantau penolakannya.
Apakah 429 harus dihitung sebagai error di monitoring?
Pisahkan dari error server. 429 adalah perilaku yang dirancang, bukan kegagalan sistem. Hitung penolakan sebagai metrik tersendiri: rasio penolakan per endpoint dan klien yang paling sering ditolak. Kalau 429 dicampur ke dalam error rate umum, alarm akan berbunyi untuk sesuatu yang sebenarnya bekerja sesuai desain.
Apakah rate limiting cukup untuk menghentikan penyalahgunaan?
Tidak. Rate limiting memperlambat dan mempersempit penyalahgunaan, tapi bukan pengganti autentikasi, otorisasi, validasi input, dan deteksi anomali. Anggap ia sebagai satu lapisan dari pertahanan berlapis: ia membuat serangan menjadi mahal dan lambat, sementara lapisan lain menangani sisanya. Referensi yang bagus untuk detail protokolnya adalah RFC 6585 untuk status 429 dan draf header RateLimit IETF untuk header kuota standar, serta panduan praktis di Moesif tentang strategi rate limiting.
Kesimpulan
Rate limiting API bukan fitur tambahan yang dipasang belakangan, melainkan bagian dari desain API yang baik. Pilih algoritma yang sesuai dengan perilaku yang kamu inginkan: fixed window untuk kesederhanaan, sliding window untuk akurasi, token bucket untuk API publik umum, leaky bucket untuk downstream yang rapuh. Terapkan batas di lapisan yang tepat, simpan counter di store bersama untuk sistem terdistribusi, dan komunikasikan batas itu dengan jujur lewat status 429, header Retry-After, dan header kuota.
Langkah berikutnya yang paling masuk akal: petakan tiga endpoint termahal di API kamu, tetapkan batas per endpoint untuk ketiganya, dan tulis satu halaman dokumentasi yang menyatakan batas itu. Setelah itu berjalan dan terpantau selama beberapa minggu, perluas kebijakan ke endpoint lain berdasarkan data penolakan yang kamu lihat, bukan berdasarkan tebakan. API yang membatasi dengan jelas akan lebih dipercaya daripada API yang runtuh diam-diam saat trafik memuncak.
Comments
Have a thought, a question, or something to add? Write it here.